Qué puede parchear automáticamente un agente de seguridad y qué debe aprobar una persona
Define límites de automatización para inventario, priorización, actualizaciones y mitigaciones según el impacto y la posibilidad de recuperar el servicio.
 Equipo enginerIT· 3 min de lectura
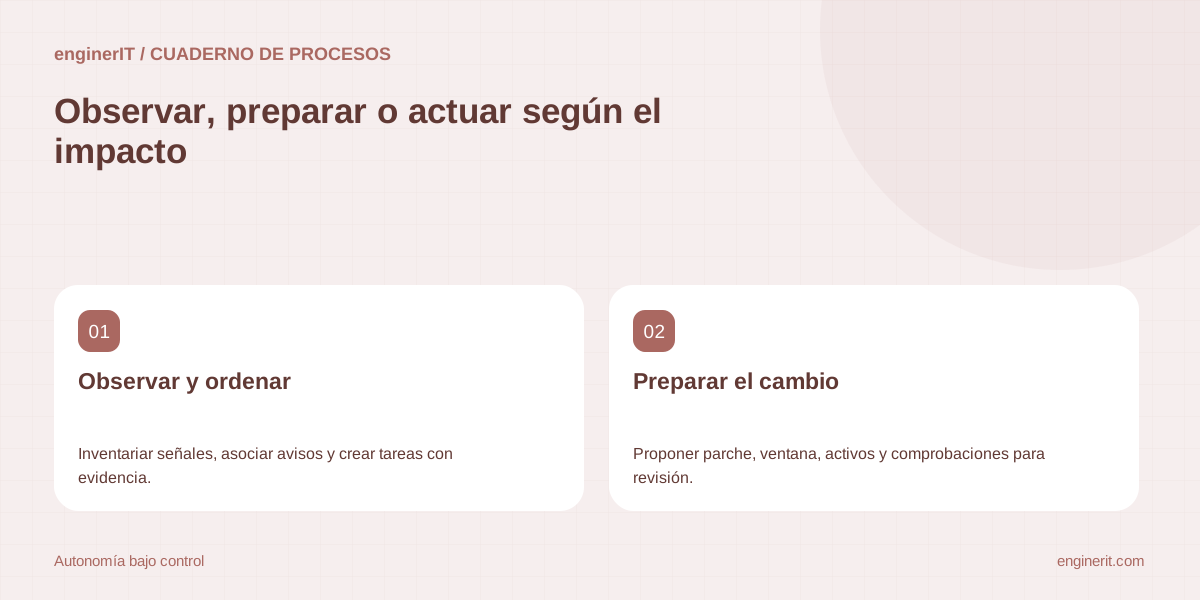
“Parcheo automático” puede describir desde crear una tarea hasta reiniciar un servidor. Define acciones, límites y recuperación por separado para que una mejora de velocidad no convierta una vulnerabilidad en una interrupción del servicio.
Enumera las acciones concretas del agente
Separa consultar inventario, relacionar CVE, asignar prioridad, crear tickets, descargar actualización, instalar, reiniciar, cambiar reglas de red y cerrar un hallazgo. Cada verbo requiere permisos y controles distintos. Evita describirlos como una sola capacidad de “remediación automática”.
Empieza por automatizar observación y preparación
Buscar coincidencias, recopilar avisos del fabricante, mostrar activos candidatos y preparar un plan son tareas que dejan la decisión visible. El resultado debería incluir fuente, fecha, versión, propietario del activo e incertidumbres para que el equipo lo compruebe.
Define acciones de bajo impacto por adelantado
Si la empresa ya autoriza alguna actualización rutinaria, limita el agente a productos, grupos y ventanas definidos. Especifica pruebas previas, condición de éxito, límite de reintentos y qué hacer cuando un activo no responde. La política debe ser aprobada por el responsable de la operación, no inferida por el modelo.
Reserva aprobación para cambios que puedan interrumpir
Reinicio, sistema crítico, dispositivo médico o industrial, servicio con horario comprometido, cambio de firewall o aislamiento del equipo pueden alterar operaciones. Requieren una aprobación y un plan de comunicación o procedimiento operativo que contemple el impacto.
Bloquea ante datos o resultados inciertos
Detén si la versión no se conoce, dos fuentes discrepan, la herramienta de destino no confirma la acción, falta propietario o la comprobación posterior falla. No cierres el hallazgo ni vuelvas a ejecutar a ciegas. Asigna la tarea a una cola con evidencia y una acción siguiente.
Separa parchear de responder a una intrusión
Una actualización puede corregir una vulnerabilidad sin aclarar si ya se explotó. Si aparecen señales de compromiso, no permitas que el agente borre registros, reinicie o aisle el equipo fuera del plan de incidentes. Escala al responsable de respuesta y conserva las evidencias según el procedimiento acordado.
Usa permisos mínimos y credenciales separadas
Concede al agente lectura para inventario y avisos, y permisos de cambio solo donde exista una acción aprobada. Separa credenciales de prueba y producción. Registra quién puede ampliar el alcance y revisa cómo revocar el acceso cuando se pausa o cambia el servicio.
Ensaya fallos antes de ampliar autonomía
Prueba actualizaciones fallidas, equipo desconectado, ventana vencida, reinicio pendiente, rollback no disponible y cambio aplicado sin confirmación. El equipo debería poder explicar qué pasó, detener nuevas acciones y completar manualmente los casos restantes.
Fuentes y documentación
- CISA · Vulnerability Response Playbook — Playbook dirigido a agencias federales; se cita como referencia de proceso, no como obligación aplicable a una pyme.
- CISA · Known Exploited Vulnerabilities Catalog — Catálogo de CISA para vulnerabilidades con evidencia de explotación conocida.
Empieza por las acciones que el equipo ya preaprueba.
Para cada cambio, escribe alcance, permiso, grupo, horario, pruebas, límite de reintentos y procedimiento de pausa. Mantén aprobación para los casos que pueden afectar continuidad o investigación de incidentes.
Cuéntanos qué necesitas →Para seguir profundizando
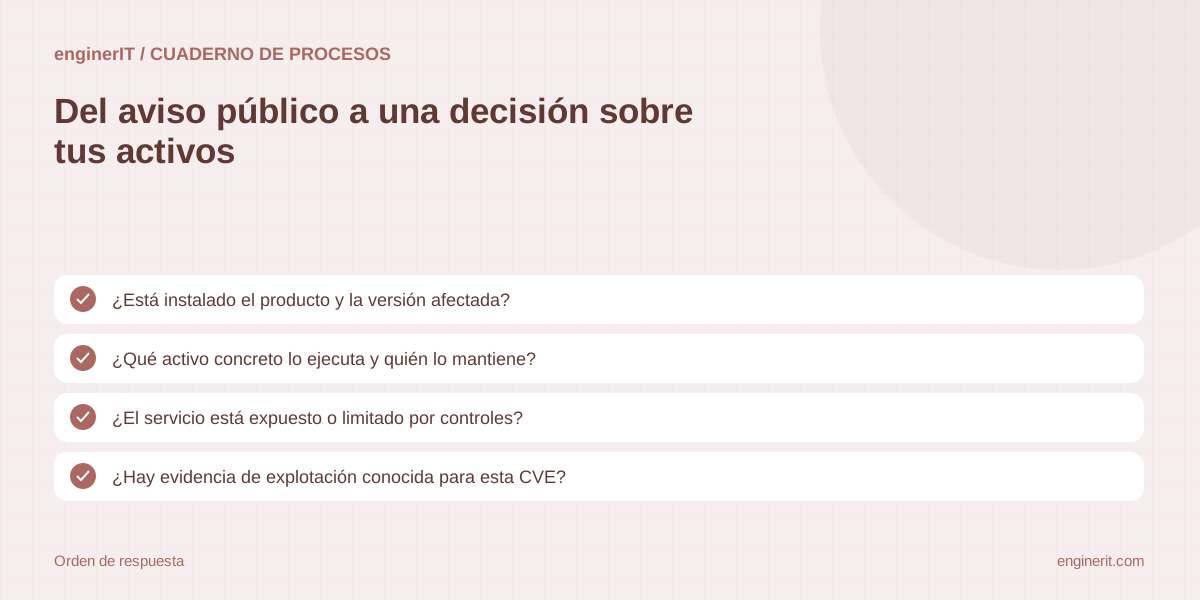
Cómo priorizar vulnerabilidades CVE en una pyme sin parchear a ciegas
Combina producto afectado, exposición, evidencia de explotación, contexto del activo y capacidad de recuperación para ordenar el trabajo de parcheo.
Leer la guía →
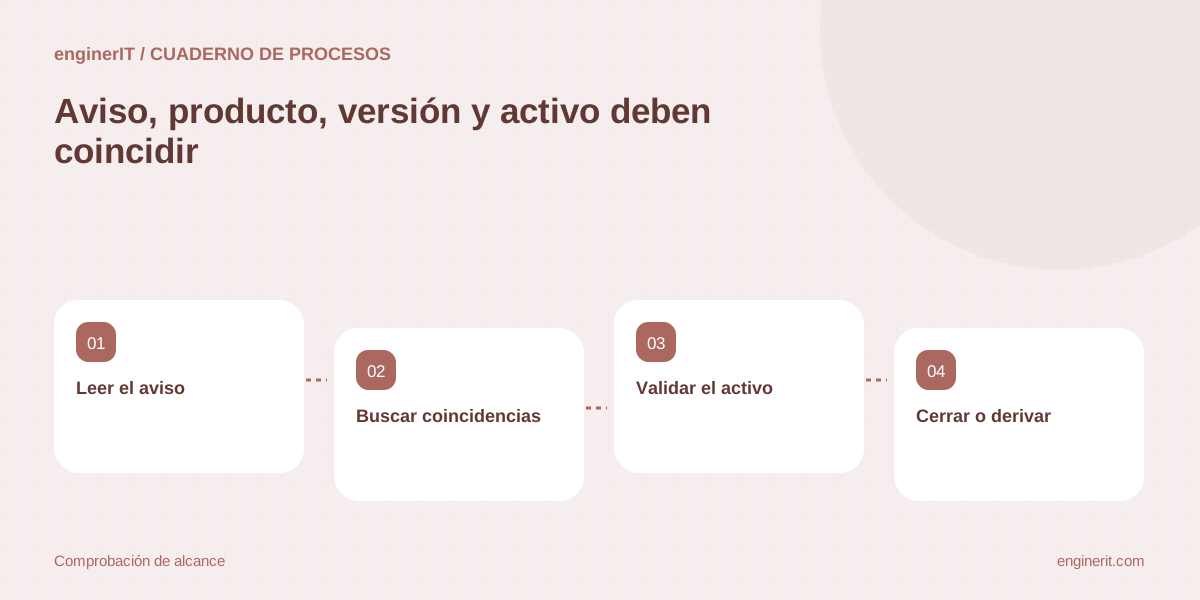
Cómo saber si una nueva CVE afecta a los equipos de tu empresa
Relaciona avisos del fabricante con versiones, configuración y activos reales, sin tratar la ausencia de datos como una confirmación.
Leer la guía →
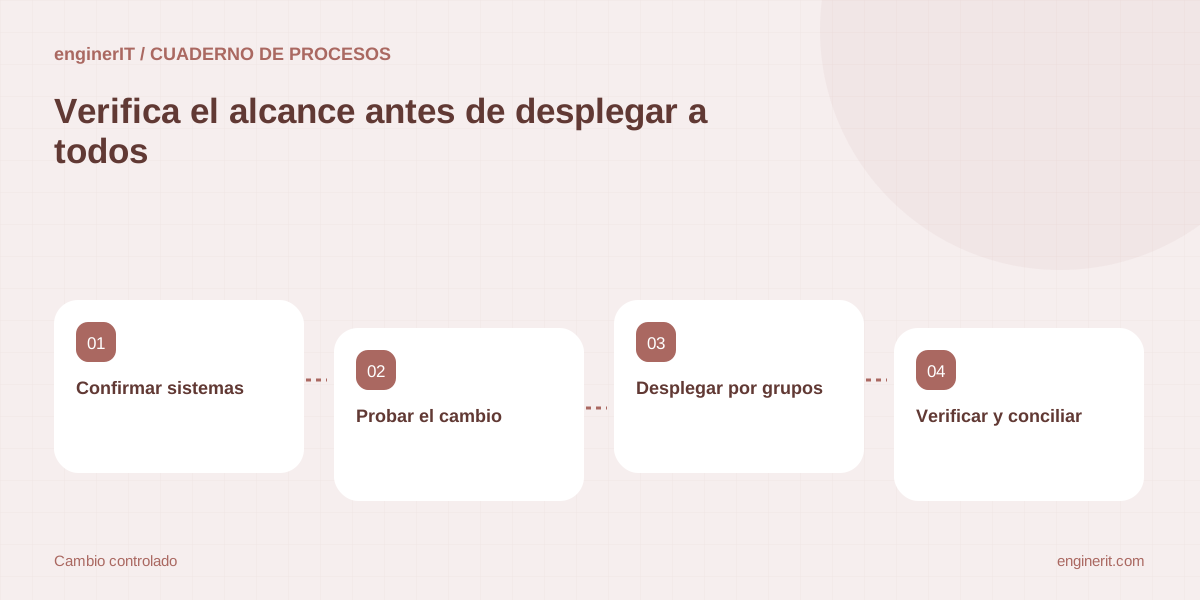
Cómo planificar parches de seguridad sin interrumpir el servicio de una pyme
Prepara alcance, pruebas, ventanas de cambio, aprobaciones, verificación y recuperación antes de actualizar sistemas que usa el negocio.
Leer la guía →