Cómo planificar parches de seguridad sin interrumpir el servicio de una pyme
Prepara alcance, pruebas, ventanas de cambio, aprobaciones, verificación y recuperación antes de actualizar sistemas que usa el negocio.
 Equipo enginerIT· 3 min de lectura
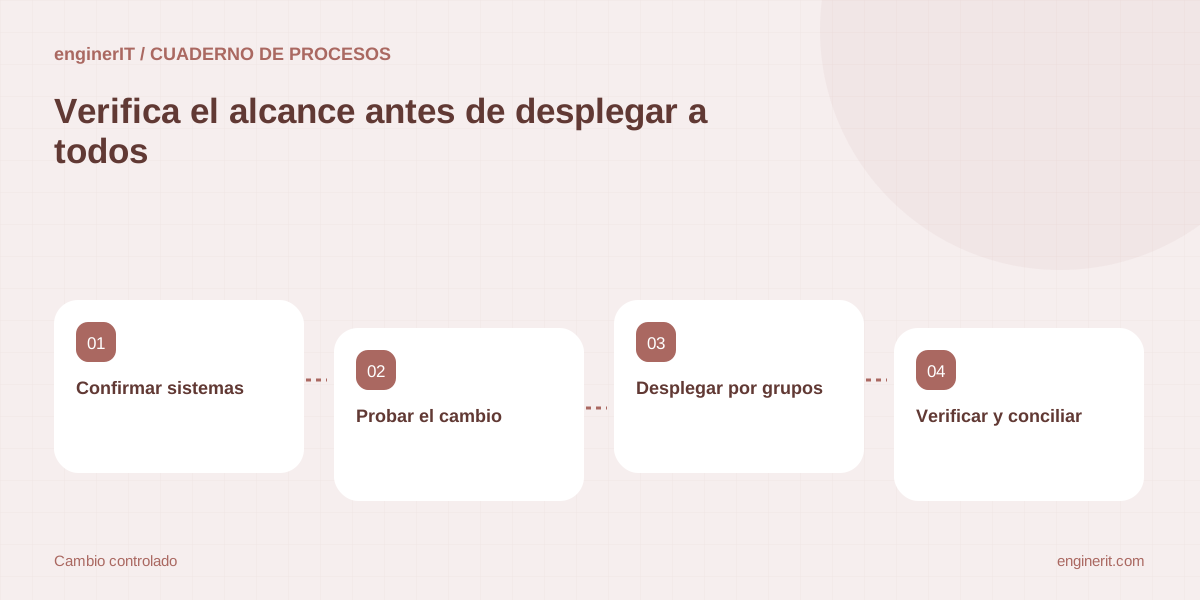
Una actualización puede requerir reinicio, cambiar dependencias o afectar un servicio que la empresa necesita. El plan debe equilibrar urgencia, impacto y posibilidad de recuperación, con un criterio explícito para avanzar, detenerse o aplicar una mitigación temporal.
Acota el cambio a activos confirmados
Identifica versiones afectadas y equipos que realmente las ejecutan. Asocia cada activo a un servicio, propietario y ventana posible. Separa sistemas desconocidos de sistemas descartados; no incluyas ni excluyas un equipo por una coincidencia débil.
Confirma el parche y las notas de versión
Lee las instrucciones del fabricante, prerrequisitos, reinicios, problemas conocidos y forma de desinstalar o volver a una configuración válida si está disponible. Si no existe un parche aplicable, define con el responsable una mitigación verificable y la fecha de reevaluación.
Evalúa impacto y dependencias
Pregunta qué operaciones dependen del servicio, cuándo pueden tolerar una pausa y qué sistemas necesitan estar disponibles durante la actualización. Define quién puede autorizar la ventana. Una clasificación automática puede reunir contexto y sugerir prioridad, pero no conoce por sí sola los compromisos operativos.
Prueba con un grupo representativo
Elige un equipo de prueba que cubra sistema operativo, aplicación y configuración relevante. Verifica instalación, inicio de servicios, acceso de usuarios y funciones esenciales. Registra errores y versiones previas. Si no hay entorno de ensayo, acuerda un despliegue piloto pequeño y una forma de detener la siguiente fase.
Despliega por etapas con barreras explícitas
Agrupa activos por propietario o servicio, define aprobador, comienzo y condición para continuar. Detén la siguiente ola si falla una comprobación, aparecen errores en el servicio o no se confirma el estado. No reintentes automáticamente en un sistema crítico si no conoces el resultado del primer intento.
Verifica la versión y el servicio después del cambio
Comprueba la versión instalada desde una fuente fiable y valida que el servicio volvió a operar. Registra activos actualizados, fallidos, fuera de línea y pendientes. “Trabajo enviado” no equivale a parche aplicado. Asigna los fallos a una cola con dueño y próxima acción.
Prepara mitigación y recuperación
Confirma copia o procedimiento de recuperación apropiado, contacto y orden de acciones antes de cambiar un servicio relevante. Si una actualización falla, detén la expansión, guarda registros y sigue el procedimiento del fabricante o de soporte. Cuando no se pueda parchear aún, registra la medida compensatoria y revisa su vigencia.
Investiga señales de compromiso por separado
Aplicar un parche corrige la exposición futura, pero no confirma que un sistema no haya sido comprometido antes del cambio. Si la evidencia o telemetría sugiere explotación, deriva al proceso de respuesta a incidentes y preserva los registros relevantes en vez de cerrar el caso como mantenimiento completado.
Fuentes y documentación
- CISA · Vulnerability Response Playbook — Playbook dirigido a agencias federales; se cita como referencia de proceso, no como obligación aplicable a una pyme.
- CISA · Known Exploited Vulnerabilities Catalog — Catálogo de CISA para vulnerabilidades con evidencia de explotación conocida.
Elige un grupo piloto y define cuándo se detiene el despliegue.
Documenta quién autoriza la ventana, qué comprobaciones validan el servicio y cómo se recupera un cambio fallido. Amplía la ola solo tras revisar el resultado del primer grupo.
Cuéntanos qué necesitas →Para seguir profundizando
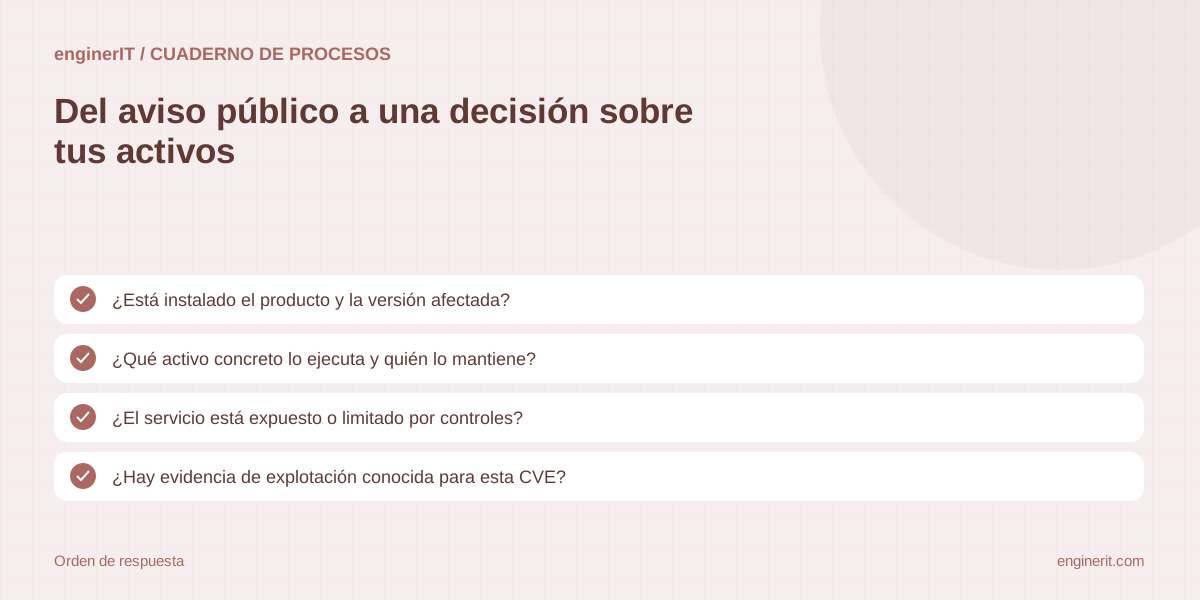
Cómo priorizar vulnerabilidades CVE en una pyme sin parchear a ciegas
Combina producto afectado, exposición, evidencia de explotación, contexto del activo y capacidad de recuperación para ordenar el trabajo de parcheo.
Leer la guía →
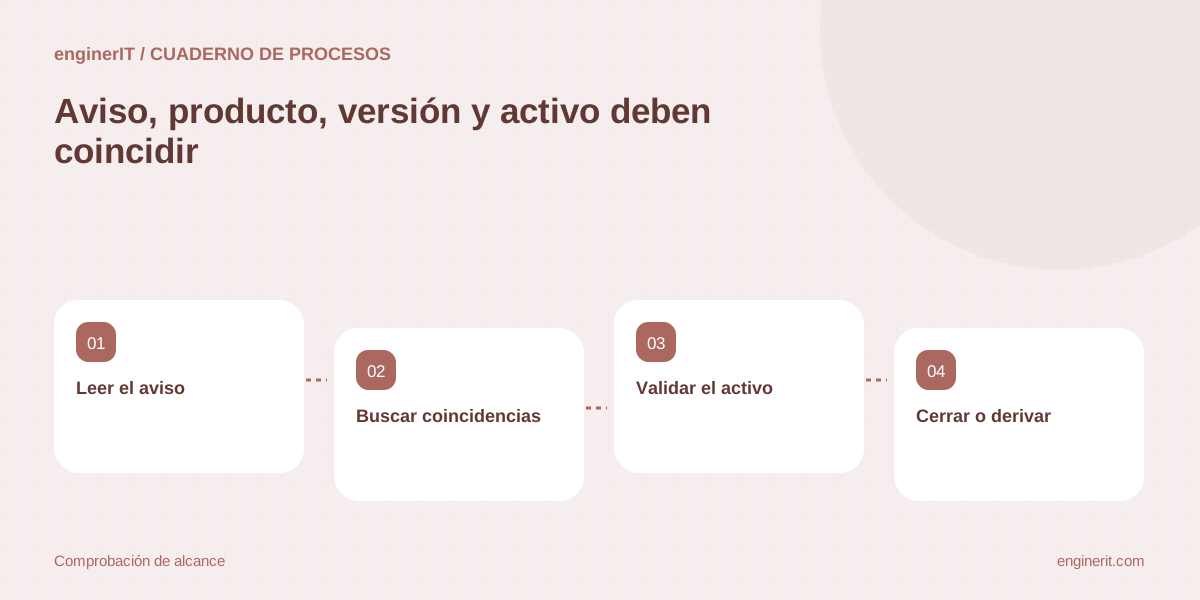
Cómo saber si una nueva CVE afecta a los equipos de tu empresa
Relaciona avisos del fabricante con versiones, configuración y activos reales, sin tratar la ausencia de datos como una confirmación.
Leer la guía →
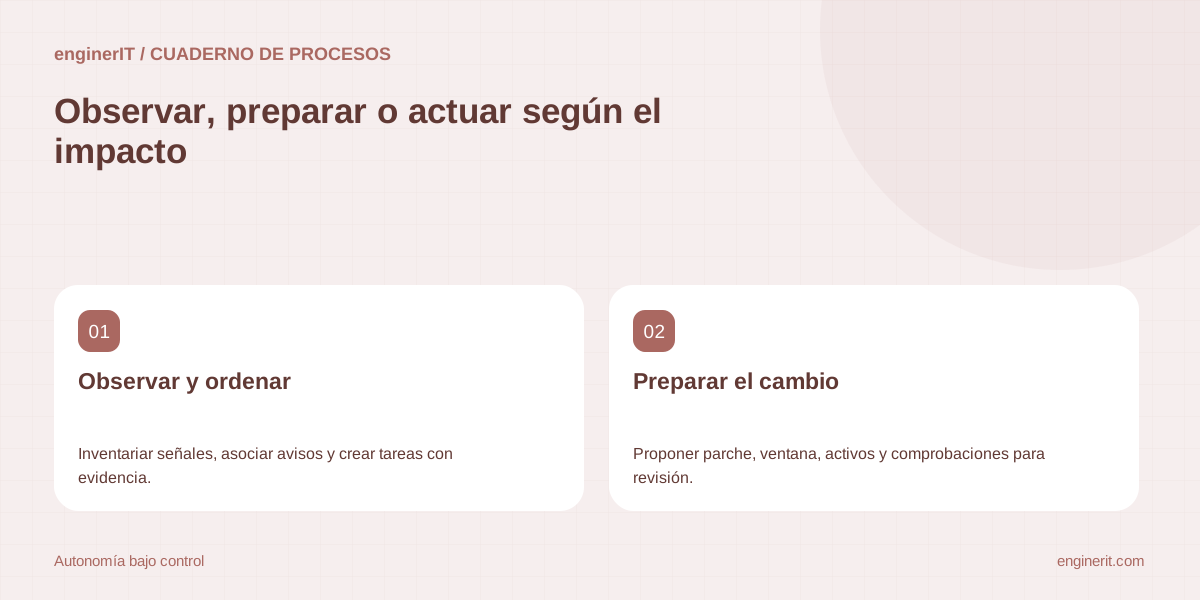
Qué puede parchear automáticamente un agente de seguridad y qué debe aprobar una persona
Define límites de automatización para inventario, priorización, actualizaciones y mitigaciones según el impacto y la posibilidad de recuperar el servicio.
Leer la guía →