Cómo automatizar parches sin romper producción en una pyme
Diseña un ciclo de prueba, aprobación, despliegue gradual, reversión y comprobación posterior.
 Equipo enginerIT· 3 min de lectura
Un parche reduce exposición, pero una actualización no probada puede interrumpir una aplicación, una impresora compartida o una integración necesaria para operar. NIST describe la gestión de parches como mantenimiento preventivo y CISA recoge remediación y mitigaciones en función del caso. Para una pyme, automatizar no significa ejecutar todo lo que aparece en un aviso: significa identificar activos, definir ventanas, probar, desplegar con alcance limitado y comprobar el resultado. El plan debe contemplar qué hacer si el servicio falla.
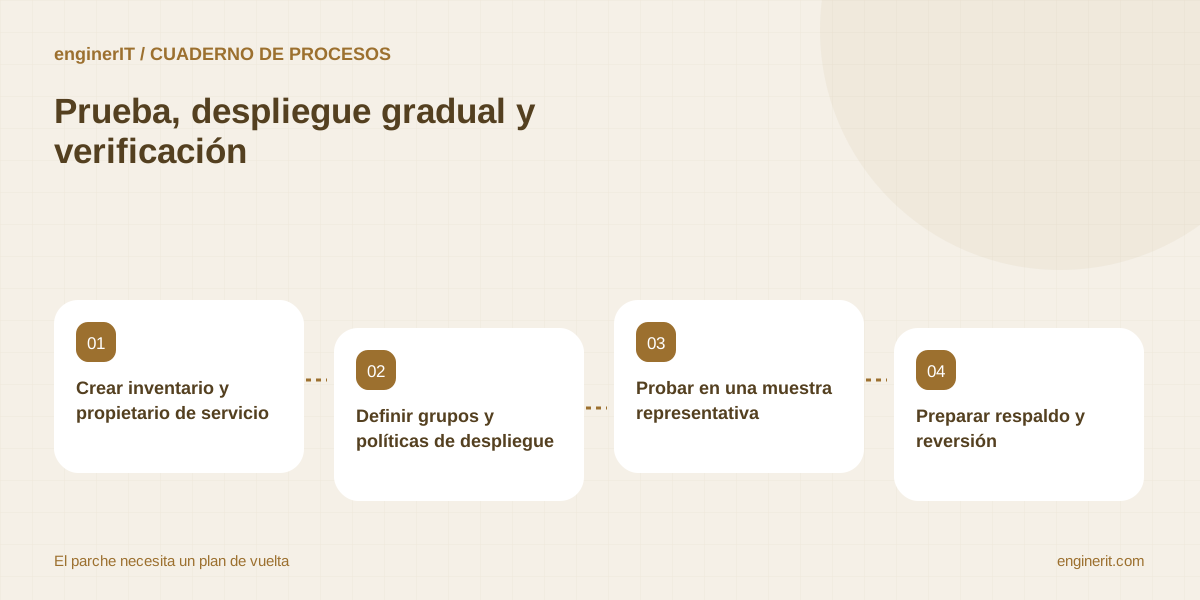
Crear inventario y propietario de servicio
Relaciona dispositivo, sistema, aplicación, versión, responsable, criticidad y ventana posible. Si no hay dueño, asigna una tarea antes de una actualización que pueda afectar a usuarios. La lista se concilia periódicamente con dispositivos reales y altas/bajas de personal.
Definir grupos y políticas de despliegue
Agrupa equipos por función, no solo por sistema operativo. Establece qué parches se aplican automáticamente, cuáles se prueban y cuáles necesitan aprobación. Documenta condiciones que permiten adelantar una intervención urgente y quién autoriza el cambio fuera de ventana.
Probar en una muestra representativa
El primer grupo debe cubrir configuraciones y dependencias reales sin incluir todos los servicios esenciales. Define señales de éxito: versión aplicada, servicio disponible y prueba funcional específica. Si falla una validación, pausa los siguientes grupos y crea una incidencia con logs pertinentes.
Preparar respaldo y reversión
Confirma respaldo reciente, datos recuperables, pasos de rollback y responsable antes de tocar un servicio crítico. Una instantánea no siempre es un respaldo restaurable ni incluye dependencias externas. La automatización comprueba que exista la referencia del plan; un profesional confirma su suficiencia.
Desplegar progresivamente y pausar ante anomalías
Aplica cambios en lotes con espera para observar errores. Si el agente detecta caída, registra señal, detiene el siguiente lote y avisa al on-call. No intentes reparación automática encadenada que pueda borrar datos, reiniciar repetidamente o ocultar el síntoma inicial.
Verificar después del cambio
Comprueba versión, reinicio pendiente, estado del servicio y una prueba funcional definida. Deja el ticket abierto si el agente solo informa que el comando terminó. Registra excepciones aprobadas y fecha de revisión para evitar que un sistema quede aplazado indefinidamente.
Medir cobertura sin optimizar a ciegas
Mide activos dentro de inventario, cumplimiento por ventana, fallos, reversión y días de exposición pendiente. Separa parche instalado de resultado verificado. Un porcentaje alto puede ocultar sistemas omitidos, por lo que revisa muestra de equipos y activos críticos periódicamente.
Fuentes y documentación
- NIST SP 800-40 Rev. 4 — Guide to Enterprise Patch Management Planning — Guía para planificar gestión empresarial de parches como mantenimiento preventivo.
- CISA — Incident and Vulnerability Response Playbooks (PDF) — Playbooks federales de respuesta; sus procedimientos pueden orientar a otras organizaciones, pero su alcance original es el gobierno federal estadounidense.
- NIST — Patch Management — Los parches corrigen problemas de seguridad y funcionalidad; su gestión debe planificarse.
Ensaya el parche en un grupo pequeño con una dependencia que no responde.
El flujo debe pausar el despliegue, conservar logs y activar el procedimiento manual de reversión.
Cuéntanos qué necesitas →Para seguir profundizando
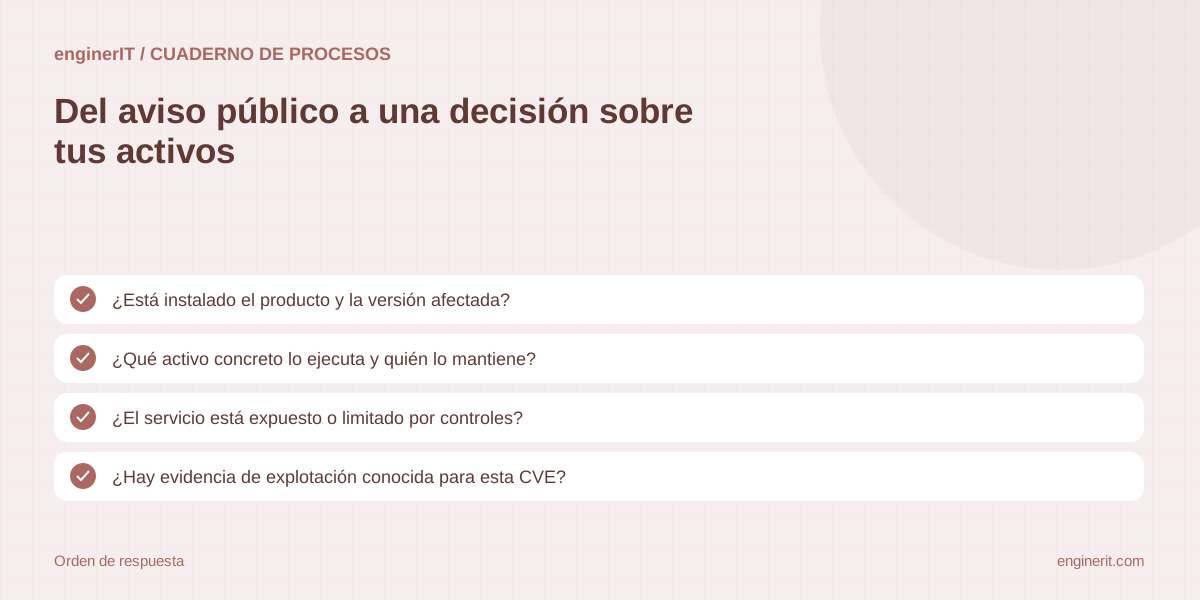
Cómo priorizar vulnerabilidades CVE en una pyme sin parchear a ciegas
Combina producto afectado, exposición, evidencia de explotación, contexto del activo y capacidad de recuperación para ordenar el trabajo de parcheo.
Leer la guía →
Cómo saber si una nueva CVE afecta a los equipos de tu empresa
Relaciona avisos del fabricante con versiones, configuración y activos reales, sin tratar la ausencia de datos como una confirmación.
Leer la guía →
Cómo planificar parches de seguridad sin interrumpir el servicio de una pyme
Prepara alcance, pruebas, ventanas de cambio, aprobaciones, verificación y recuperación antes de actualizar sistemas que usa el negocio.
Leer la guía →