Cuándo una alerta técnica necesita abrir una incidencia
Una alerta debe abrir una incidencia cuando exige una actuación coordinada, amenaza un servicio o necesita seguimiento hasta recuperar un estado aceptable. No todas las medidas fuera de rango merecen un ticket, pero ninguna señal relevante debe quedar sin una decisión trazable.
 Equipo enginerIT· 2 min de lectura
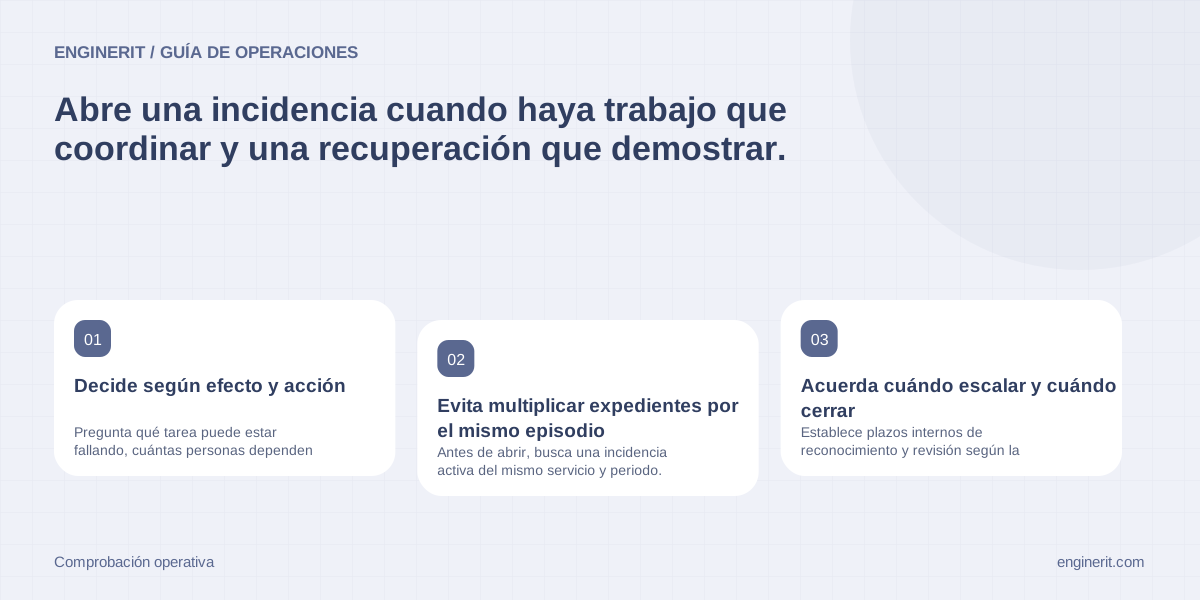
Una alerta debe abrir una incidencia cuando exige una actuación coordinada, amenaza un servicio o necesita seguimiento hasta recuperar un estado aceptable. No todas las medidas fuera de rango merecen un ticket, pero ninguna señal relevante debe quedar sin una decisión trazable.
Decide según efecto y acción
Pregunta qué tarea puede estar fallando, cuántas personas dependen de ella y cuánto puede esperar la respuesta. Una métrica alta sin impacto puede requerir observación o planificación; una transacción crítica fallida puede justificar intervención aunque el servidor siga respondiendo. Registra esa diferencia en la regla.
Define quién puede clasificar la señal y qué primera comprobación debe realizar. Si hay indicios de seguridad, dirige la información al procedimiento especializado correspondiente. No esperes a demostrar la causa para registrar un efecto relevante, pero separa los hechos observados de las hipótesis.
Evita multiplicar expedientes por el mismo episodio
Antes de abrir, busca una incidencia activa del mismo servicio y periodo. Relaciona alertas de componentes con el caso principal cuando exista una dependencia confirmada. Conserva las señales asociadas para investigar; agrupar no significa descartarlas ni afirmar una causa común sin comprobarla.
Prometheus recomienda alertas orientadas a síntomas y acciones. Traduce ese criterio a una ficha: condición observada, impacto posible, comprobación inicial y responsable. Si nadie sabe qué hacer ante una señal, revisa el propósito de la regla; añadir destinatarios no resuelve la ausencia de un procedimiento.
Acuerda cuándo escalar y cuándo cerrar
Establece plazos internos de reconocimiento y revisión según la criticidad, sin inventar compromisos que el equipo no puede cubrir. Si falta información, asigna igualmente un propietario y un siguiente paso. Una incidencia puede permanecer en diagnóstico sin declararse resuelta por silencio.
Cierra después de verificar la tarea afectada y registrar el resultado. Distingue recuperación automática de corrección definitiva: si el servicio se recupera solo, puede seguir siendo necesario investigar recurrencias. Revisa una muestra de alertas sin ticket y de tickets creados automáticamente para encontrar problemas ocultos, duplicados y reglas que consumen atención sin generar decisiones útiles.
Comprobaciones para cerrar la tarea
- ✓ Regla indica efecto, acción y propietario.
- ✓ Se revisan casos activos antes de abrir otro.
- ✓ Cierre verifica recuperación y decide seguimiento de recurrencias.
Fuentes y documentación
- Prometheus: Alerting practices — Recomienda alertar sobre síntomas accionables y comprobar la cadena de monitorización y notificación.
Aplicarlo en tu empresa
Podemos revisar el entorno y acordar qué actuaciones, validaciones y mantenimiento necesitas.
Conocer el servicio relacionado →