Cómo probar un agente de IA antes de usarlo con clientes o en operaciones
Prepara casos normales y difíciles, define criterios de aprobación y verifica acciones, errores, derivaciones y recuperación antes de ampliar el uso.
 Equipo enginerIT· 3 min de lectura
Una demostración preparada enseña que el agente puede seguir un camino conocido. Una prueba operativa tiene que comprobar además que reconoce límites, no repite acciones y deja a una persona suficiente información para continuar cuando algo sale mal.
Escribe criterios antes de mirar resultados
Define qué salida es correcta, qué campos son críticos, qué errores son tolerables para el piloto y qué comportamiento debe bloquear cualquier activación. Si se acuerdan los criterios después de ver el resultado, es fácil justificar una salida que el equipo habría rechazado con anterioridad.
Construye un conjunto pequeño pero variado
Incluye ejemplos reales autorizados o datos de ensayo que representen canales, formatos y complejidades distintas. Separa casos habituales de situaciones límite. Conserva la entrada original y la respuesta esperada, con una explicación de por qué cada caso importa para la operación.
Evalúa campos críticos por separado
No puntúes solo si el resumen “parece razonable”. Comprueba referencias, fechas, importes u otros datos que puedan producir una acción equivocada. Registra valor esperado, valor obtenido, fragmento de origen y efecto del error. Un promedio alto no debe esconder fallos repetidos en un campo determinante.
Comprueba herramientas y permisos
Verifica qué consulta el agente, qué puede cambiar y qué ocurre cuando una llamada devuelve error o datos vacíos. Prueba acceso denegado, registros duplicados y una actualización que falla después de una lectura exitosa. Confirma que el agente no declare terminado un trabajo cuyo cambio no se guardó.
Prueba la derivación y la abstención
Para entradas ambiguas, no autorizadas o fuera del alcance, comprueba que la salida se detiene y llega a la cola correcta. La derivación debe incluir entrada, contexto consultado, motivo y siguiente paso pendiente. Cuenta falsas derivaciones y casos que deberían haberse detenido pero siguieron.
Simula recuperación y repetición
Ensaya una respuesta que se pierde tras ejecutar una acción y un reintento posterior. Usa identificadores de idempotencia o comprobaciones de estado si están disponibles en la integración. Si no puedes confirmar si el cambio ocurrió, el flujo debe pedir conciliación en lugar de volver a ejecutarlo a ciegas.
Pide una revisión que pueda cambiar el despliegue
Entrega resultados al responsable de la operación y deja que rechace el piloto. Registra problemas, quién los resolvió y qué casos hay que volver a probar. Solo amplía canales, volumen o permisos tras repetir las pruebas afectadas y documentar qué límites permanecen.
Deja una decisión de lanzamiento auditable
Anota versión probada, muestra utilizada, criterios, errores abiertos, límites conocidos, responsable que acepta el uso y plan de vuelta atrás. Si una incidencia se acepta temporalmente, indica la fecha o condición para revisarla. Al cambiar el modelo, las instrucciones, los datos o las herramientas, repite los casos relacionados y compara con el resultado anterior.
Antes de ponerlo en marcha
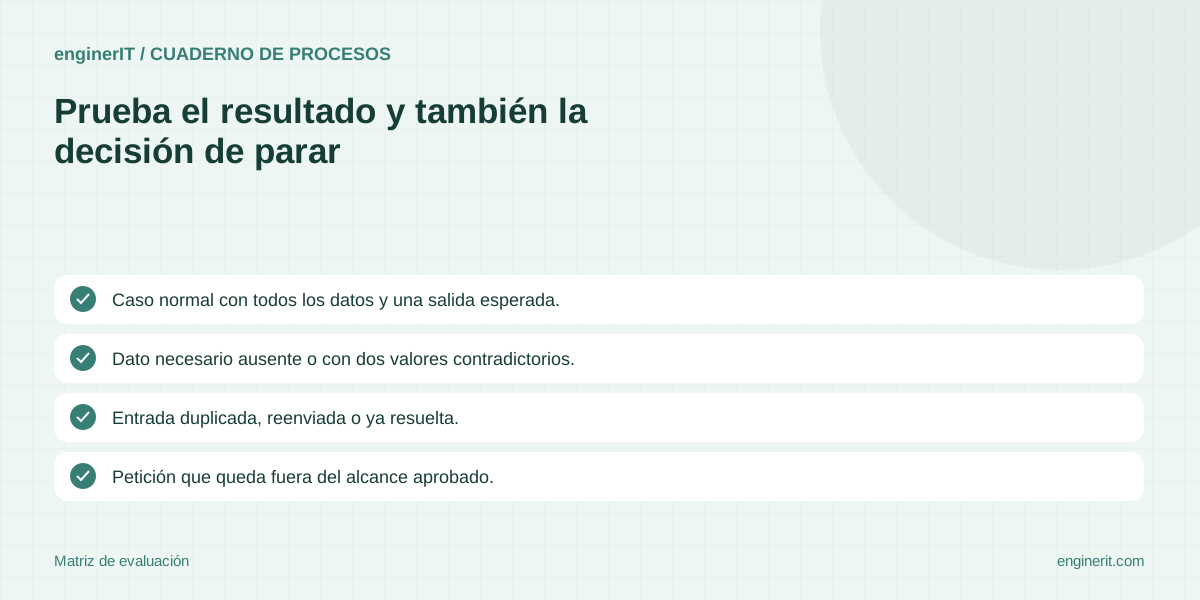
- ✓ Caso normal con todos los datos y una salida esperada.
- ✓ Dato necesario ausente o con dos valores contradictorios.
- ✓ Entrada duplicada, reenviada o ya resuelta.
- ✓ Petición que queda fuera del alcance aprobado.
- ✓ Herramienta lenta, desconectada o con permiso denegado.
- ✓ Rechazo, corrección o ausencia de respuesta humana.
- ✓ Reintento después de una ejecución parcial.
Prepara casos límite junto con quien operará el flujo.
Acordad qué falla obliga a parar, quién revisa cada salida y cómo se confirma que una acción se guardó. Si las pruebas no pueden reproducirse, el equipo tampoco podrá investigar una incidencia real.
Cuéntanos qué necesitas →Para seguir profundizando
Agente de IA o chatbot: qué necesita realmente una pyme
Una guía práctica para distinguir respuestas automáticas de agentes que consultan sistemas y preparan trabajo.
Leer la guía →
Cómo diseñar la revisión humana en un agente de IA para una pyme
Decide qué puede ejecutar un agente, qué debe presentar para aprobación y cómo diseñar una parada útil ante incertidumbre.
Leer la guía →
Cómo conectar un agente de IA a los sistemas de una pyme con permisos claros
Define qué sistema manda en cada dato, qué puede consultar el agente y qué cambios quedan sujetos a aprobación antes de integrar herramientas.
Leer la guía →