Cómo pausar un agente de IA sin perder trabajo pendiente
Prepara un mecanismo de parada, una cola de operaciones abiertas y un procedimiento seguro para reanudar después de una incidencia.
 Equipo enginerIT· 3 min de lectura
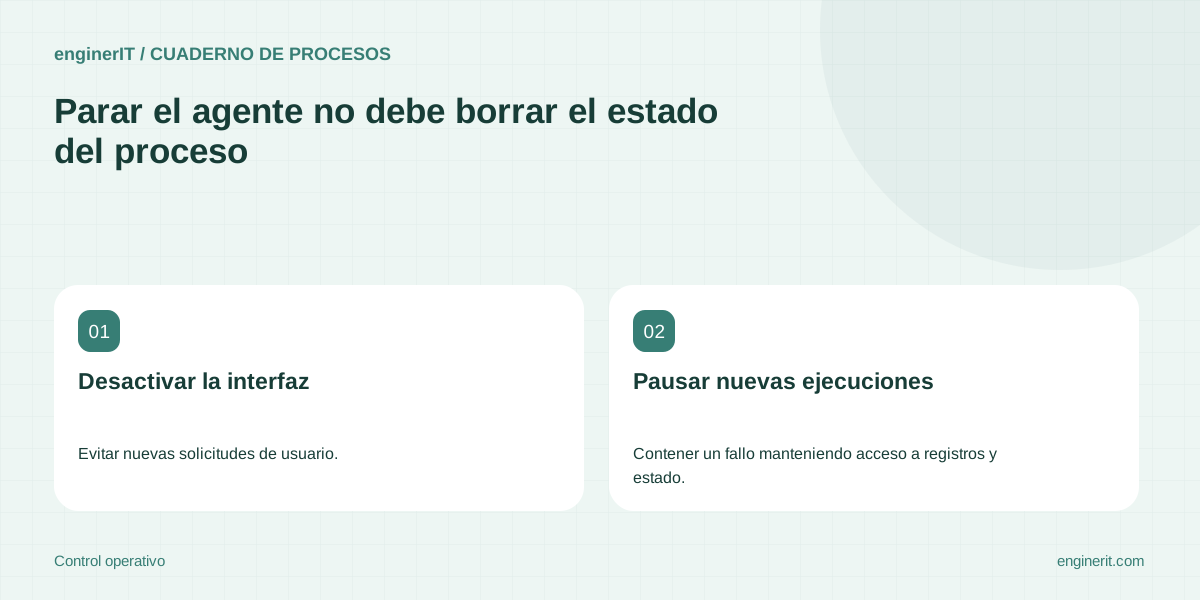
Una pausa puede ser necesaria por respuestas erróneas, cambios en una fuente o una integración inestable. Si solo se apaga el botón visible, un trabajo en segundo plano podría seguir escribiendo; si se revoca una cuenta sin conocer su alcance, otros flujos pueden fallar. La parada debe cubrir acciones, estado y recuperación.
Define quién puede activar la pausa
Acordad roles autorizados, señales que justifican detener nuevas ejecuciones y dónde queda registrada la decisión. Puede ser una persona técnica o responsable del proceso según el incidente. No dependas de que el único desarrollador esté disponible; documenta cómo localizar la configuración y a quién avisar.
Detén nuevas acciones con efecto
Distingue recibir solicitudes, consultar fuentes, preparar borradores y escribir en sistemas. Durante una pausa, quizá quieras mantener consultas o alertas mientras bloqueas cambios. Especifica qué componentes se detienen y comprueba que colas, tareas programadas, reintentos y webhooks respetan el mismo estado.
Conserva el estado de operaciones en curso
Registra qué casos estaban pendientes, enviados, aprobados o sin confirmación. No descartes la cola ni marques todas las acciones como fallidas. Una escritura puede haberse aplicado antes de la pausa; verifica el sistema destino antes de volver a ejecutar ese paso.
Activa una ruta manual para el trabajo esencial
Decide qué equipo recoge solicitudes durante la pausa y dónde registra entradas nuevas. Asigna dueño, canal y prioridades para evitar que el proceso desaparezca en una bandeja personal. Si el volumen supera la capacidad manual, comunica qué tareas se retrasan y quién puede tomar una decisión de continuidad.
Investiga antes de reanudar
Aísla ejemplos afectados, identifica fuente o integración implicada y decide qué casos requieren corrección. Revisa permisos, versiones y cambios recientes. Una reanudación no debería depender de que el error deje de aparecer durante unos minutos; fija una comprobación concreta que demuestre que el fallo se ha entendido o que el alcance está contenido.
Reanuda por un grupo acotado
Empieza con un conjunto pequeño de operaciones y revisa cada resultado junto a la persona responsable. Mantén bloqueadas las acciones de alto impacto hasta confirmar el comportamiento. Si la prueba falla, vuelve a la pausa y conserva el diagnóstico; no amplíes porque una consulta respondió correctamente.
Reconcilia lo que se hizo durante el modo manual
Compara solicitudes atendidas manualmente con las que quedaron en la cola automática. Comprueba si alguna se duplicó, cambió de estado o quedó sin respuesta. Usa un identificador común y asigna quién sincroniza los registros antes de permitir que el agente vuelva a procesar casos antiguos.
Ensaya la parada cuando el sistema funciona
Incluye una simulación de error, una operación ya enviada, una confirmación tardía y una reanudación parcial. Verifica quién recibe la alerta y qué estado ve cada persona. El ejercicio revela permisos y documentación faltante antes de que una incidencia real obligue a improvisar.
Prueba la pausa con una integración de bajo impacto y una cola de ensayo.
Detén nuevas escrituras, comprueba qué pasa con las operaciones enviadas y procesa manualmente un caso. Define condiciones observables de reanudación y quién reconcilia la cola antes de activar el agente.
Cuéntanos qué necesitas →Para seguir profundizando
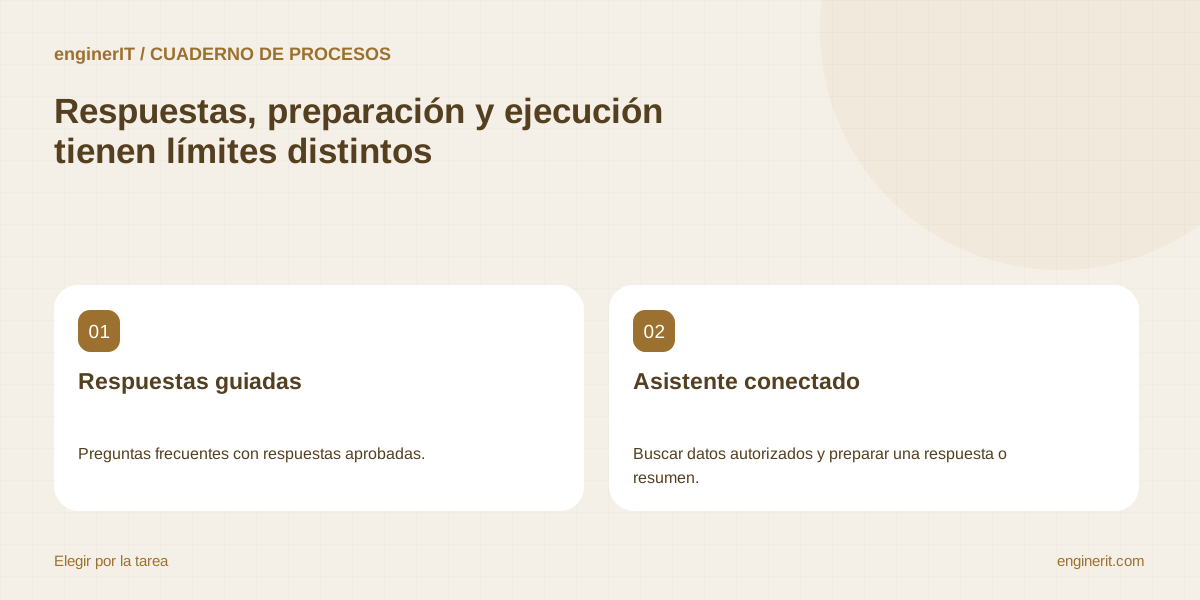
Agente de IA o chatbot: qué necesita realmente una pyme
Una guía práctica para distinguir respuestas automáticas de agentes que consultan sistemas y preparan trabajo.
Leer la guía →
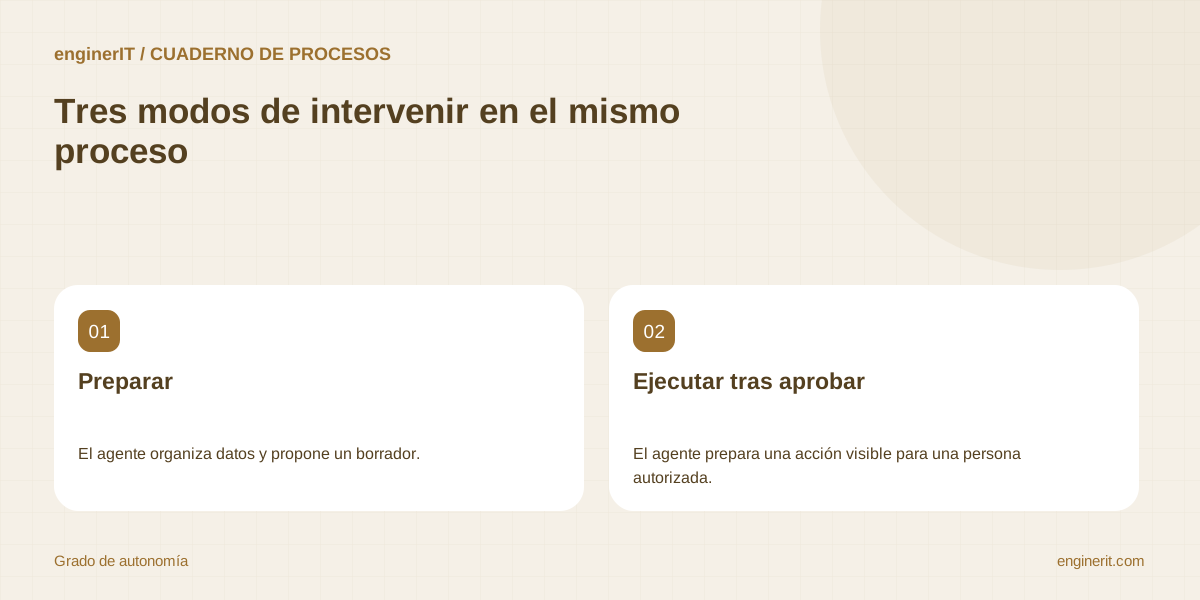
Cómo diseñar la revisión humana en un agente de IA para una pyme
Decide qué puede ejecutar un agente, qué debe presentar para aprobación y cómo diseñar una parada útil ante incertidumbre.
Leer la guía →
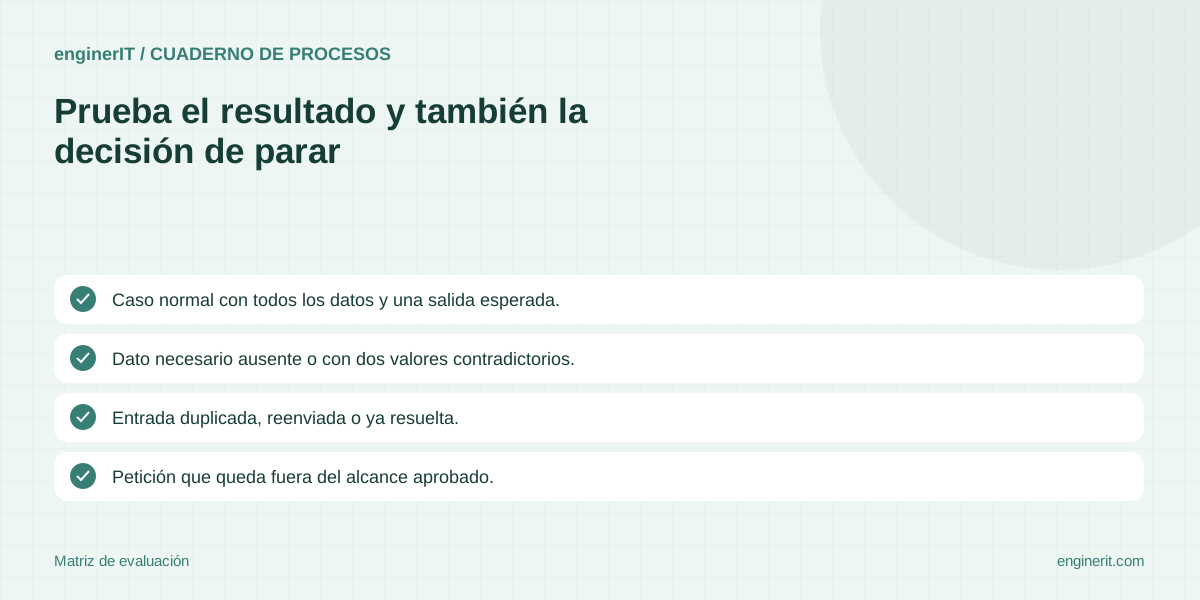
Cómo probar un agente de IA antes de usarlo con clientes o en operaciones
Prepara casos normales y difíciles, define criterios de aprobación y verifica acciones, errores, derivaciones y recuperación antes de ampliar el uso.
Leer la guía →