Cómo escalar un ticket a soporte técnico con evidencia útil
Prepara un paquete reproducible para el siguiente nivel de soporte sin enviar datos sensibles ni perder las pruebas ya recogidas.
 Equipo enginerIT· 3 min de lectura
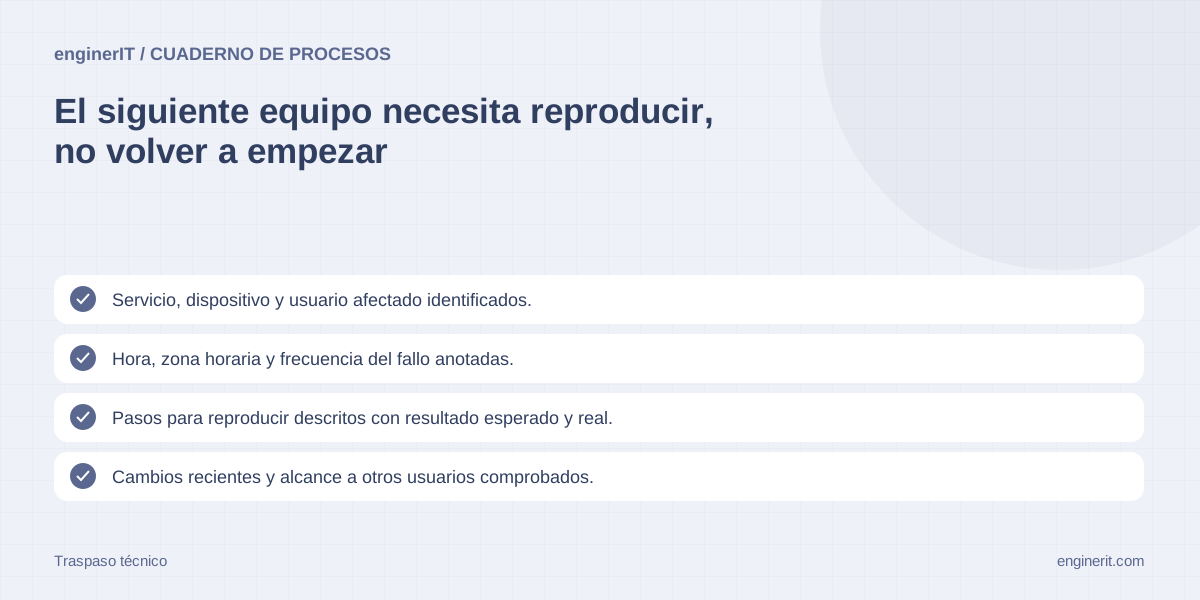
“Sigue fallando” deja al siguiente técnico sin forma de distinguir un problema repetido de una nueva condición. Un escalado útil empaqueta los pasos reproducibles, los registros relevantes, el alcance y las pruebas ya realizadas, manteniendo la información necesaria y evitando trasladar datos personales o secretos por canales no aprobados.
Resume el resultado que necesita la persona
Anota la tarea de negocio afectada y lo que la persona esperaba que ocurriera. Después describe qué pasó en realidad y cuándo. La formulación ayuda a evitar que un error visual menor se convierta en la descripción de un fallo de facturación o que un bloqueo real se reduzca a “no funciona”.
Incluye pasos mínimos para reproducir
Enumera estado inicial, acción realizada y resultado observado. Indica si ocurre siempre, a veces o solo en una cuenta o dispositivo. Si el fallo depende de un permiso o red concreta, anótalo sin incluir credenciales. Pide al siguiente nivel que confirme si pudo reproducirlo con esos mismos pasos.
Anota momento, alcance y cambios cercanos
Incluye fecha y zona horaria, personas o equipos afectados, ubicación o red si resulta relevante y qué cambió recientemente. Separa coincidencia temporal de causa confirmada. Un despliegue reciente puede ser una pista, pero el escalado debe evitar presentarlo como causa antes de comprobarlo.
Adjunta pruebas con contexto y cuidado
Relaciona cada captura o registro con el momento y paso correspondiente. Recorta tokens, direcciones personales, contenido de clientes y otros datos que no necesite el receptor. Usa el canal interno aprobado para intercambiar registros; un archivo reenviado por correo puede conservar información oculta aunque el texto visible parezca seguro.
Registra qué pruebas ya se hicieron
Para cada acción, describe quién la realizó, qué esperaba y qué resultado observó. Indica si cerrar sesión, probar otro navegador o reiniciar alteró el problema y si interrumpió trabajo. Evita repetir pasos disruptivos solo porque aparecen en una plantilla de soporte.
Conserva dueño y comunicación con el usuario
El escalado cambia el equipo que investiga, pero alguien debe seguir siendo responsable de la comunicación y del próximo control. Define cuándo revisar el caso si el proveedor no responde y qué información se puede compartir con el usuario. No prometas un plazo de solución que el equipo receptor no haya confirmado.
Devuelve la resolución al expediente original
Cuando llega una respuesta, anota causa confirmada o hipótesis, cambio realizado, condiciones en que se comprobó y persona que verificó. Si la recomendación no solucionó el problema, conserva el resultado para el siguiente escalado. Evita cerrar el caso con una respuesta del proveedor sin comprobar si la tarea original ya funciona.
Reduce escalados de baja calidad con datos del proceso
Mide casos que vuelven por falta de contexto, pruebas que hubo que repetir y escalados sin actualizaciones. Revisa si el formulario pide demasiado o deja fuera un dato que el técnico realmente utiliza. Ajusta la guía de recogida según casos resueltos y confirma el cambio con el equipo receptor.
Antes de ponerlo en marcha
- ✓ Servicio, dispositivo y usuario afectado identificados.
- ✓ Hora, zona horaria y frecuencia del fallo anotadas.
- ✓ Pasos para reproducir descritos con resultado esperado y real.
- ✓ Cambios recientes y alcance a otros usuarios comprobados.
- ✓ Capturas o registros recortados para ocultar datos sensibles.
- ✓ Pruebas realizadas y efectos secundarios registrados.
- ✓ Persona de contacto y ventana disponible para reproducir.
Recupera un ticket que volvió al primer nivel y localiza qué evidencia faltaba.
Usa ese caso para crear una ficha de escalado específica para la herramienta o servicio. Pide al técnico receptor que valide los campos antes de convertirla en requisito del formulario.
Cuéntanos qué necesitas →Para seguir profundizando
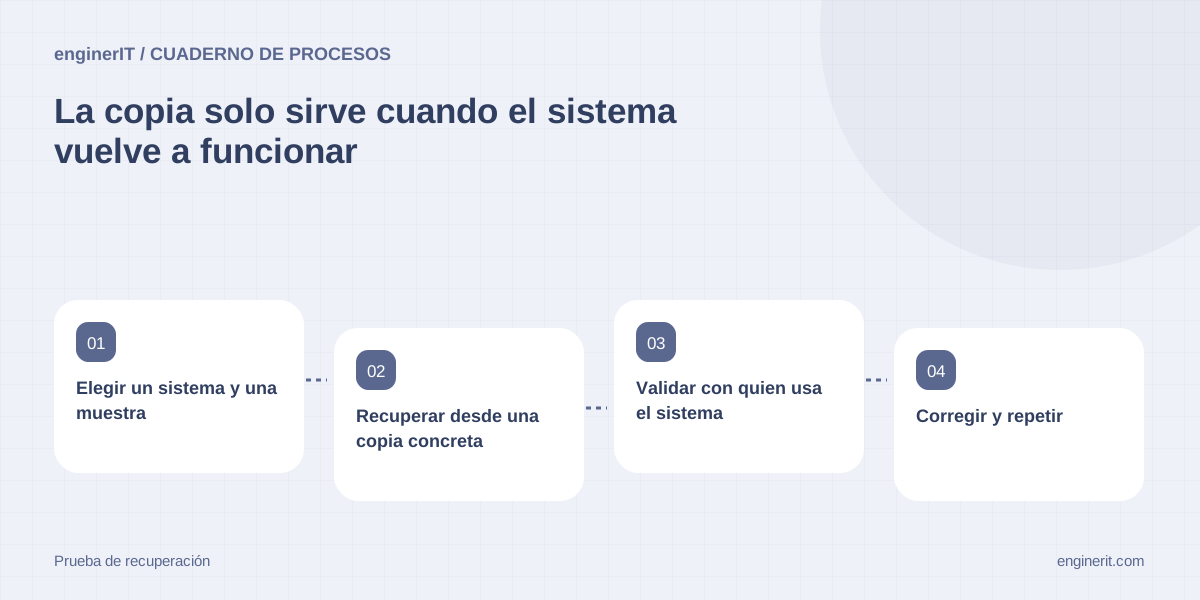
Cómo probar que una copia de seguridad se puede restaurar
Prepara una prueba acotada de recuperación con sistemas, responsables, dependencias y criterios de aceptación definidos antes de necesitarla.
Leer la guía →
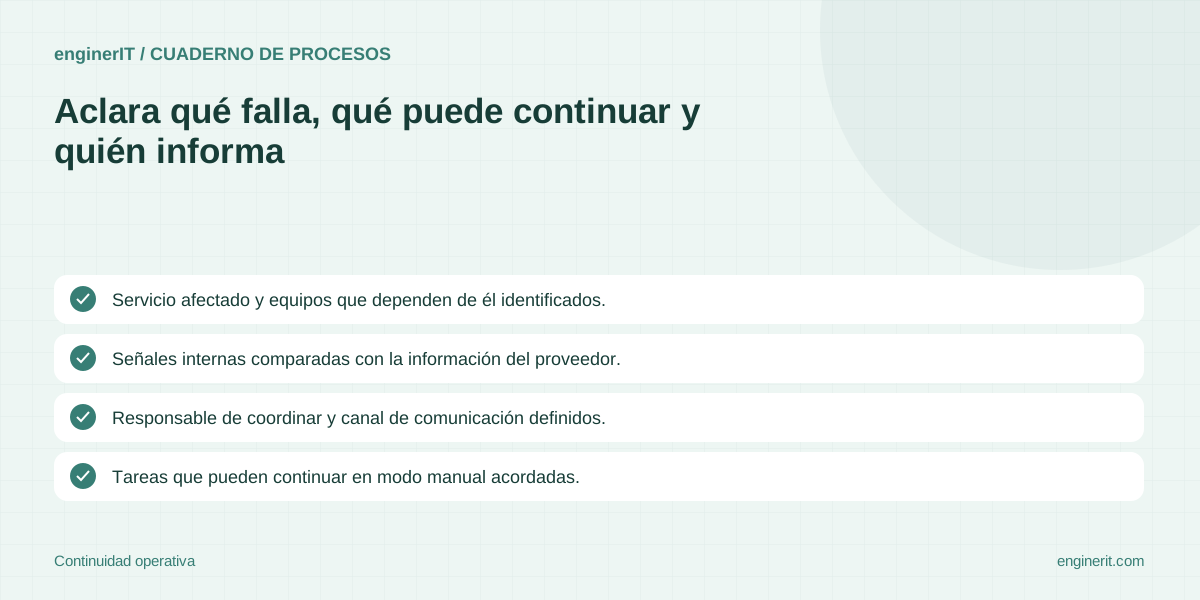
Cómo coordinar una caída de un servicio cloud en una pyme
Organiza detección, comunicación, alternativa temporal y recuperación cuando una herramienta online crítica deja de responder.
Leer la guía →
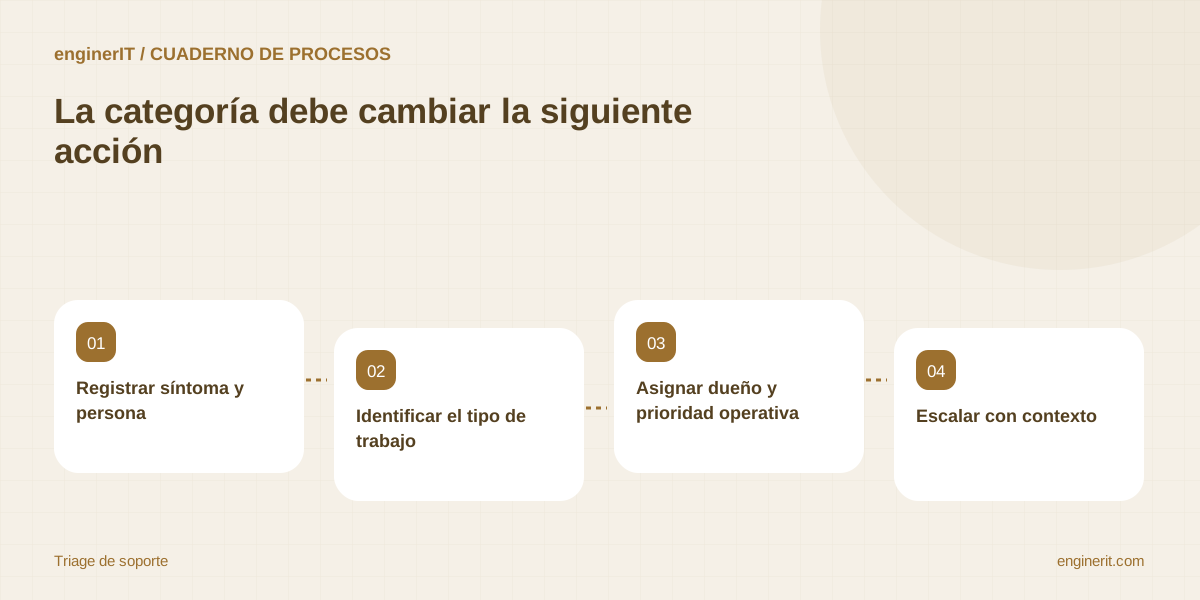
Cómo clasificar solicitudes e incidencias de soporte IT sin perder casos
Crea una cola que distinga interrupciones, peticiones, accesos y consultas, con información mínima, dueño y ruta de escalado.
Leer la guía →