Cómo clasificar solicitudes e incidencias de soporte IT sin perder casos
Crea una cola que distinga interrupciones, peticiones, accesos y consultas, con información mínima, dueño y ruta de escalado.
 Equipo enginerIT· 3 min de lectura
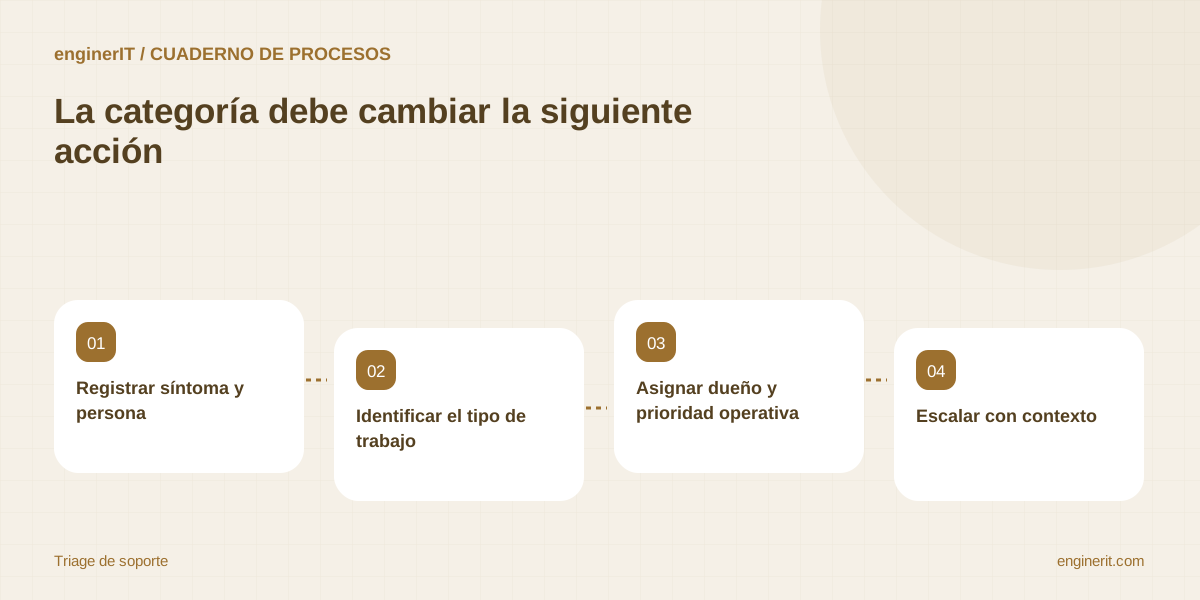
Una bandeja de soporte donde contraseña, portátil averiado, permiso nuevo e interrupción general tienen la misma etiqueta deja a los técnicos reconstruyendo el contexto. La clasificación debe permitir asignar, pedir los datos mínimos y reconocer cuándo una incidencia supera a una persona o afecta a un servicio compartido.
Define categorías que cambien el trabajo
Empieza con unas pocas rutas comprensibles: algo que dejó de funcionar, una petición de acceso o configuración, una consulta y un cambio planificado. Escribe ejemplos y exclusiones para cada una. Si dos categorías llegan a la misma persona y tienen los mismos pasos, quizá no necesiten etiquetas separadas en la primera versión.
Recoge el síntoma en palabras del usuario
Guarda el servicio, error visible, momento aproximado, equipo afectado y qué tarea no puede completar. No obligues a la persona a conocer el nombre técnico del sistema. Una captura o mensaje puede ayudar, pero el formulario debe evitar pedir credenciales, secretos o información no necesaria para diagnosticar el problema.
Pregunta por alcance e impacto observable
Averigua si ocurre a una persona o a varias, si existe una alternativa y qué trabajo quedó bloqueado. Define reglas internas para escalar una interrupción amplia o una actividad crítica. La prioridad no debería basarse solo en el cargo de quien escribe o en el tono del mensaje; registra el impacto que justifica la decisión.
Enruta sin ocultar casos mal clasificados
Un agente puede proponer categoría y equipo según el texto y datos existentes. Si la información es insuficiente o dos rutas encajan, solicita revisión y mantiene el caso visible. Cuando el técnico corrige la categoría, guarda la original y el motivo para mejorar ejemplos y reglas. No cierres automáticamente un ticket porque se parece a uno ya resuelto.
Identifica duplicados sin fusionar síntomas distintos
Agrupa informes que parecen describir la misma interrupción y muestra qué equipos y horarios coinciden. Mantén cada solicitante vinculado al caso principal para informar a todos y capturar impactos diferentes. Una misma aplicación puede tener dos fallos simultáneos; un técnico confirma si deben relacionarse o tratarse como incidencias separadas.
Haz visible dueño, siguiente paso y espera
Cada caso abierto necesita responsable, acción siguiente y motivo de espera. Si se ha pedido información al usuario o al proveedor, registra qué falta y cuándo revisar de nuevo. Evita estados genéricos como “en curso” que no distinguen diagnóstico activo, dependencia externa y solución esperando confirmación.
Cierra cuando se verifica el resultado
Define qué demuestra que el caso está resuelto: el usuario completa la tarea, el servicio vuelve a responder o la solicitud fue aplicada y confirmada. Si una persona no contesta, usa la política acordada de cierre por inactividad y deja claro que no hubo verificación. Mantén disponible una forma de reabrir con el historial.
Usa el patrón de casos para reducir trabajo repetido
Revisa temas recurrentes, tiempos de espera, reasignaciones y casos devueltos por falta de información. Si muchas solicitudes necesitan la misma aclaración, mejora el formulario o publica una guía concreta. Una reducción de tickets no es el único objetivo: comprueba que el usuario puede resolver la tarea y encontrar ayuda cuando el autoservicio no funciona.
Clasifica una muestra de tickets ya cerrados y compara con el técnico.
Incluye una incidencia de varias personas, una petición de acceso, una consulta incompleta y un falso duplicado. Anota qué dato cambió la ruta y usa ese resultado para diseñar el formulario mínimo.
Cuéntanos qué necesitas →Para seguir profundizando
Cómo probar que una copia de seguridad se puede restaurar
Prepara una prueba acotada de recuperación con sistemas, responsables, dependencias y criterios de aceptación definidos antes de necesitarla.
Leer la guía →
Cómo coordinar una caída de un servicio cloud en una pyme
Organiza detección, comunicación, alternativa temporal y recuperación cuando una herramienta online crítica deja de responder.
Leer la guía →
Cómo escalar un ticket a soporte técnico con evidencia útil
Prepara un paquete reproducible para el siguiente nivel de soporte sin enviar datos sensibles ni perder las pruebas ya recogidas.
Leer la guía →