Cómo limitar los intentos de una tarea que nunca termina bien
Limita una tarea mediante intentos totales, tiempo transcurrido y fecha de utilidad.
 Equipo enginerIT· 2 min de lectura
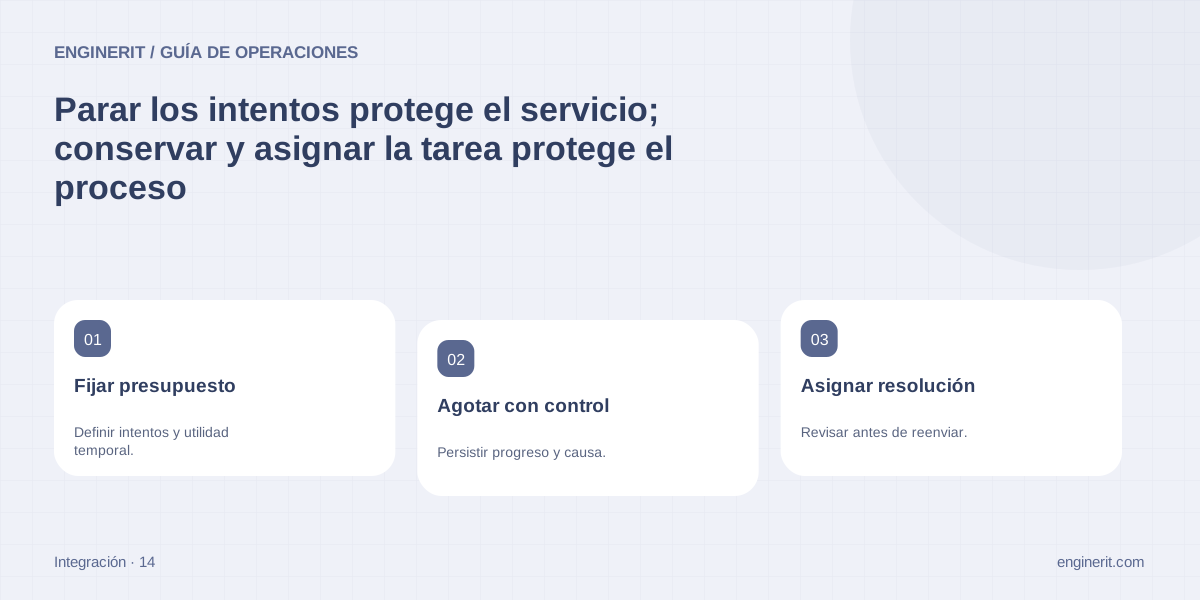
Limita una tarea mediante intentos totales, tiempo transcurrido y fecha de utilidad. Cuando alcance cualquiera de esos límites, sácala del circuito automático con estado visible y responsable. Un contador en memoria se pierde al reiniciar y puede convertir un máximo aparente en una repetición indefinida.
Elige límites que respondan al negocio
Define qué fallo es repetible y cuánto tiempo sigue teniendo sentido la acción. Una actualización de inventario puede esperar de forma distinta que un aviso de una cita ya pasada. Guarda fecha de creación, intentos acumulados y último motivo de fallo junto a la tarea. Aclara si los intentos de un SDK cuentan dentro del máximo y evita que mover el mensaje a otra cola borre el historial.
Distingue tarea problemática y servicio caído
Si falla un solo registro por sus datos, apártalo sin detener los demás cuando sean independientes. Si muchas tareas fallan contra el mismo recurso, reduce tráfico o pausa el destino; gastar el máximo de cada una a la vez empeora la recuperación. Azure describe el riesgo de reintentos agresivos y la utilidad de interrumpir llamadas ante fallos persistentes. El alcance de la pausa debe corresponder al componente afectado, no bloquear sin motivo toda la integración.
Prepara una salida que conserve el trabajo
Al agotar el límite, registra causa, referencias, pasos confirmados y acción requerida. Una cola de mensajes apartados puede ser útil, pero no equivale a resolución automática. Service Bus documenta su dead-letter queue y exige atenderla: no presupongas limpieza ni revisión por el mero hecho de habilitarla. Asigna seguimiento por antigüedad para que un trabajo detenido no quede invisible al dejar de producir errores.
Comprueba reinicio y reenvío manual
Provoca un fallo persistente, reinicia al trabajador y confirma que el presupuesto no vuelve a cero. Intenta reenviar sin corregir la causa: el procedimiento debe pedir una decisión y conservar la relación con la tarea original. Si se autoriza otra ejecución, evita repetir pasos ya aplicados. Verifica también una tarea nueva y válida para comprobar que el mecanismo no ha bloqueado todo el proceso. Mide tareas agotadas y tiempo hasta su resolución, además del número de intentos.
Comprobaciones para cerrar la tarea
- ✓ El contador y la fecha límite sobreviven al reinicio.
- ✓ Los fallos de un destino no consumen toda la cola sin control.
- ✓ Un reenvío conserva motivo, autor y relación con el original.
Fuentes y documentación
- Azure Architecture Center: Retry — Distingue fallos transitorios, límites de intentos e impacto de políticas anidadas.
- Azure Service Bus: dead-letter queues — Mensajes apartados para inspección y reenvío; la cola no se limpia automáticamente.
Aplicarlo en tu empresa
Podemos revisar el entorno y acordar qué actuaciones, validaciones y mantenimiento necesitas.
Conocer el servicio relacionado →