Plan de continuidad si falla un agente de IA o una integración
Define cómo detectar la caída, proteger trabajos pendientes, volver al procedimiento manual y reconciliar la cola al recuperar el servicio.
 Equipo enginerIT· 3 min de lectura
Una integración puede dejar de responder por un cambio de credenciales, una caída del proveedor, una cuota alcanzada o una modificación en el sistema de destino. Si el equipo solo descubre el fallo cuando un cliente reclama, la automatización ha creado un punto ciego. El plan de continuidad define cómo detectar la interrupción, qué tareas conservar, quién toma el control y cómo reanudar sin perder solicitudes ni crear duplicados.
Clasifica procesos por impacto y plazo
Anota qué tareas pueden esperar, cuáles requieren intervención el mismo día y qué compromisos dependen de una respuesta. Acuerda la clasificación con operaciones y atención al cliente. Una etiqueta técnica de disponibilidad no determina por sí sola la prioridad de negocio.
Define señales observables de degradación
Controla errores, tiempo sin confirmación, crecimiento de cola y respuestas inesperadas del sistema conectado. Designa un umbral y una persona receptora del aviso. Una página del proveedor en verde no confirma que la cuenta de la pyme, sus credenciales o sus permisos funcionen.
Protege y presenta trabajos pendientes
Conserva identificador, entrada original, estado, último paso completado y próximo intento permitido. Evita eliminar la cola al reiniciar o reenviar todos los casos sin comprobar el sistema final. La vista para el operador debe mostrar si el agente llegó a crear un registro antes de fallar.
Prepara el modo manual
Documenta dónde consultar el dato fuente, cómo registrar que una persona tomó el caso y qué alternativa usar si la aplicación principal tampoco está disponible. Mantén instrucciones accesibles fuera del sistema afectado. El formulario de contingencia debe pedir solo la información necesaria para evitar una copia descontrolada.
Aclara cuándo pausar acciones
Define qué fallo detiene nuevas escrituras, envíos o cambios y quién puede activar la pausa. Si no se sabe si una operación terminó, deriva a revisión antes de repetirla. Una alerta que no puede bloquear la acción no protege contra cobros, reservas o comunicaciones duplicadas.
Comunica al equipo y a clientes con criterio
Prepara un aviso interno con el estado, alcance, alternativa y próxima actualización. Si el retraso afecta a clientes, el responsable de servicio valida el mensaje y evita prometer una hora de recuperación no confirmada. No ocultes una incidencia con una respuesta automática que diga que la gestión terminó.
Reconcilia al recuperar el proveedor
Compara cola con registros del sistema de destino y clasifica procesado, fallido, duplicado y pendiente. Reanuda por lotes pequeños con control de idempotencia. Mantén una lista de casos gestionados a mano para que el flujo no los vuelva a crear al sincronizar.
Ensaya escenarios con las personas implicadas
Simula una credencial caducada, servicio lento y resultado incierto después de una escritura. Cronometra detección, aviso y recuperación; registra dudas y actualiza el procedimiento. El ejercicio también confirma que el equipo tiene permisos y tiempo para ejecutar el modo manual.
Cierra la incidencia y corrige la causa
Registra periodo, tareas afectadas, impacto confirmado, medida temporal y causa conocida o pendiente. Revisa si el aviso llegó a la persona correcta y si el procedimiento evitó pérdida o duplicación. Acordad una acción con responsable y fecha, y valida el cambio con otra prueba.
Antes de ponerlo en marcha
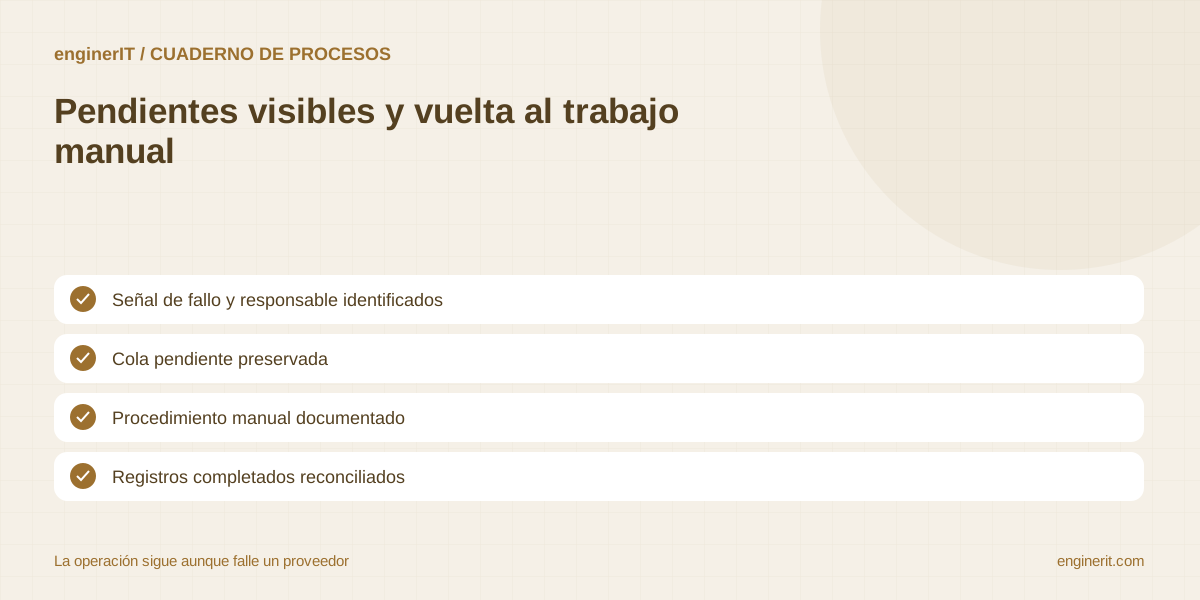
- ✓ Señal de fallo y responsable identificados
- ✓ Cola pendiente preservada
- ✓ Procedimiento manual documentado
- ✓ Registros completados reconciliados
- ✓ Reanudación validada por responsable
Ensaya una caída del conector después de crear un registro, pero antes de confirmar.
El procedimiento debe permitir comprobar si el registro existe antes de reintentar la operación.
Cuéntanos qué necesitas →Para seguir profundizando
Cómo hacer un inventario de procesos antes de automatizar una pyme
Localiza tareas repetidas, excepciones, sistemas implicados y responsables para elegir un primer flujo automatizable con criterio.
Leer la guía →
Cómo calcular el coste total de un agente de IA para una pyme
Incluye integración, supervisión, consumo, mantenimiento y gestión de excepciones en una estimación comparable al proceso actual.
Leer la guía →
Cómo delegar tareas a un agente de IA sin perder el seguimiento
Entrega objetivo, contexto, límites y criterio de finalización; conserva un responsable humano para cada resultado delegado.
Leer la guía →