Cómo medir la calidad de un agente de IA antes de ponerlo ante clientes
Construye una evaluación con ejemplos reales anonimizados, criterios de aceptación, errores críticos y revisión periódica.
 Equipo enginerIT· 3 min de lectura
Un agente puede contestar de forma convincente y aun así omitir una condición, inventar un plazo o ejecutar una acción que el equipo no autorizó. Antes de conectarlo a un buzón o sistema real, prepara una evaluación que mida tanto la utilidad como los fallos que detendrían el despliegue. La prueba no necesita un laboratorio complejo: puede empezar con una colección controlada de solicitudes representativas, criterios escritos por las personas responsables y un procedimiento para revisar discrepancias.
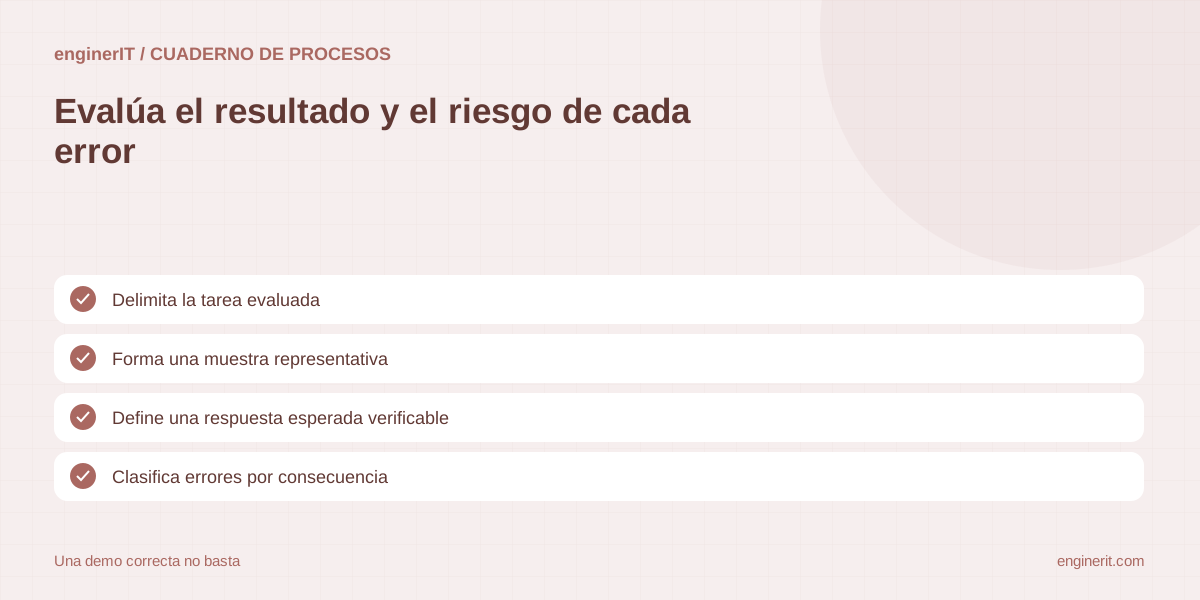
Delimita la tarea evaluada
Especifica qué entrada recibe el agente, qué salida debe producir y qué herramientas puede usar. Si extracción, resumen y envío son tareas distintas, puntúalas por separado. Una evaluación ambigua no revela si el error ocurrió al leer el documento, aplicar la regla o llamar a una herramienta.
Forma una muestra representativa
Incluye casos habituales, formatos variados, información ausente, contradicciones, correcciones y ejemplos que deben rechazarse o derivarse. Usa datos ficticios o anonimizados con acceso autorizado. No construyas la muestra solo con los ejemplos limpios que se usaron para configurar el sistema.
Define una respuesta esperada verificable
Para cada ejemplo, indica campos que deben aparecer, fuente válida, acciones permitidas y resultado aceptable. Cuando haya varias respuestas correctas, documenta el rango de variación. Así el revisor puede puntuar la evidencia y no su preferencia por una frase concreta.
Clasifica errores por consecuencia
Distingue un problema de estilo de un dato falso, una omisión comercial, una exposición de información o una acción no autorizada. Define cuáles son críticos y bloquean el paso a producción aunque el promedio general sea alto. Conserva recuentos por tipo para dirigir las mejoras.
Puntúa extracción y decisiones por separado
Compara los campos capturados con el documento y revisa luego la decisión que produjo el agente. Un importe mal leído no es el mismo fallo que aplicar mal una tarifa correcta. Esta separación ayuda a saber si se necesita mejorar OCR, instrucciones, datos maestros o reglas.
Incluye herramientas, permisos y fallos técnicos
Prueba registros inexistentes, permisos denegados, servicio lento, resultado vacío y reintento. Comprueba si el agente informa incertidumbre, conserva el borrador y evita duplicar una escritura. Una respuesta correcta en una conversación simulada no demuestra que la integración opere de forma segura.
Haz revisión humana ciega cuando puedas
Oculta al evaluador qué versión generó cada resultado y usa una pauta común. Si dos personas discrepan, resuelven el criterio y actualizan la guía antes de ampliar la muestra. Guarda ejemplos problemáticos y decisión adoptada para que futuras comparaciones sean consistentes.
Compara versiones bajo las mismas condiciones
Mantén el conjunto de casos, permisos, parámetros y herramientas constantes al probar un cambio. Registra versión, fecha, coste, latencia y errores. Si cambia el modelo o la fuente de datos, identifica ese cambio; comparar dos ejecuciones con condiciones distintas puede atribuir una mejora al factor equivocado.
Define el umbral y el seguimiento
Acordad qué puntuación mínima se exige, qué fallos son bloqueantes, cuánta revisión se hará al inicio y cuándo se repite la prueba. En producción, toma una muestra de resultados, registra correcciones y activa una pausa si aparece un error crítico. La aceptación inicial no es una garantía permanente.
Prepara diez casos normales y cinco que el agente debe derivar.
Acordad antes de ejecutarlos qué error bloquearía el piloto y quién puede aprobar su reanudación.
Cuéntanos qué necesitas →Para seguir profundizando
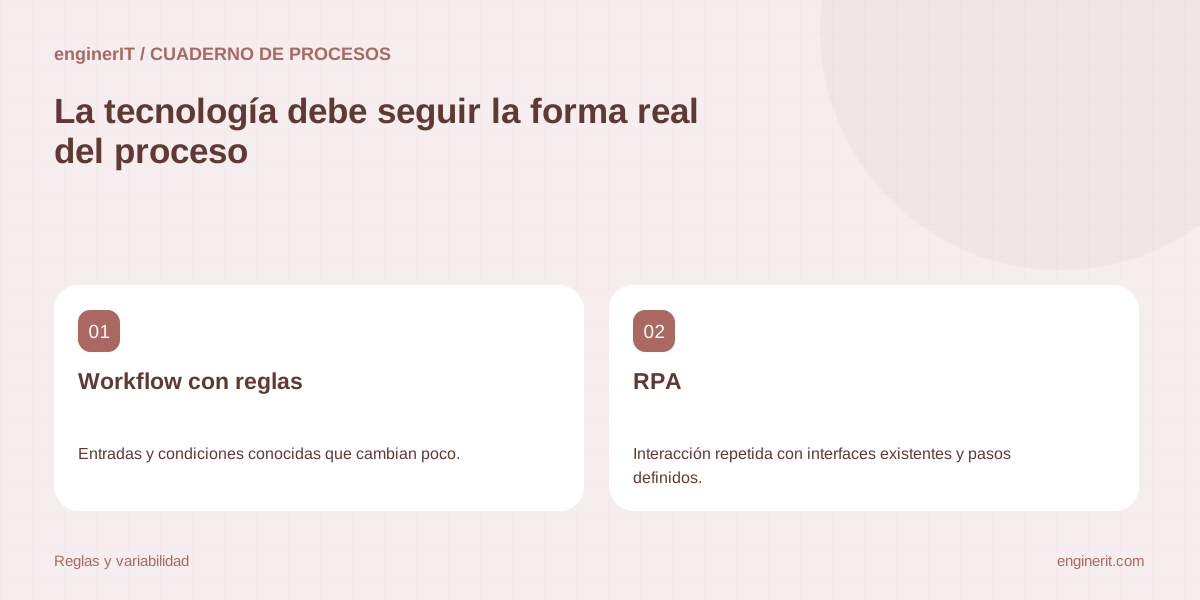
Workflow, RPA o agente de IA: cómo elegir el tipo de automatización
Compara variabilidad, fuentes, decisiones y tolerancia a errores para seleccionar una solución que encaje con el proceso.
Leer la guía →
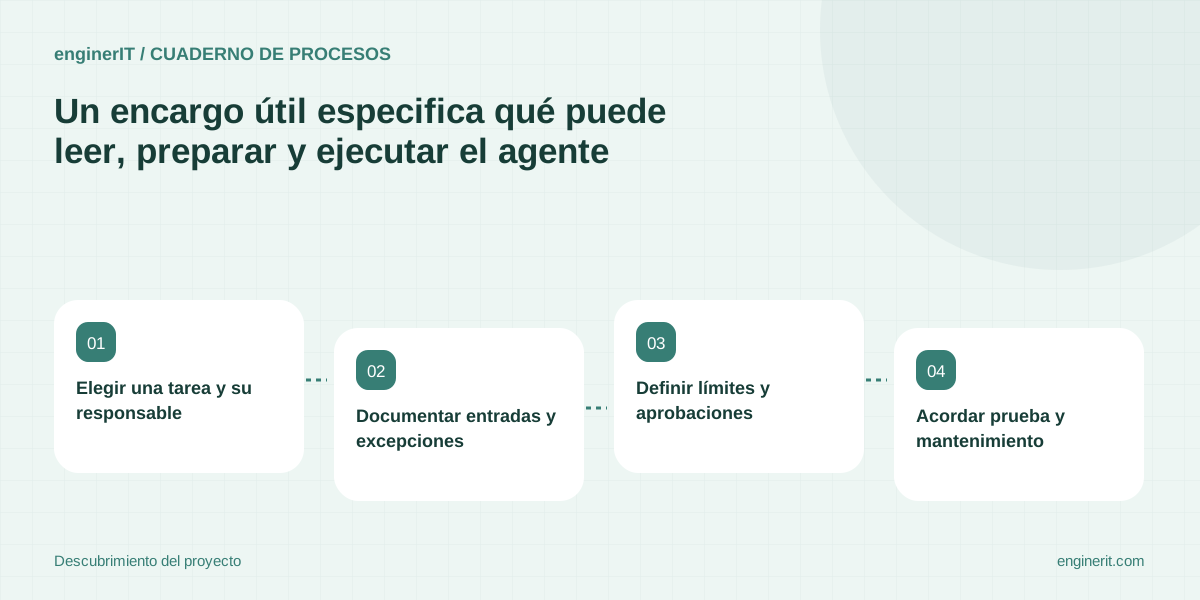
Cómo preparar los requisitos de un proyecto de agente de IA para una empresa
Define tarea, fuentes, acciones, límites, supervisión y criterios de aceptación antes de pedir una propuesta.
Leer la guía →
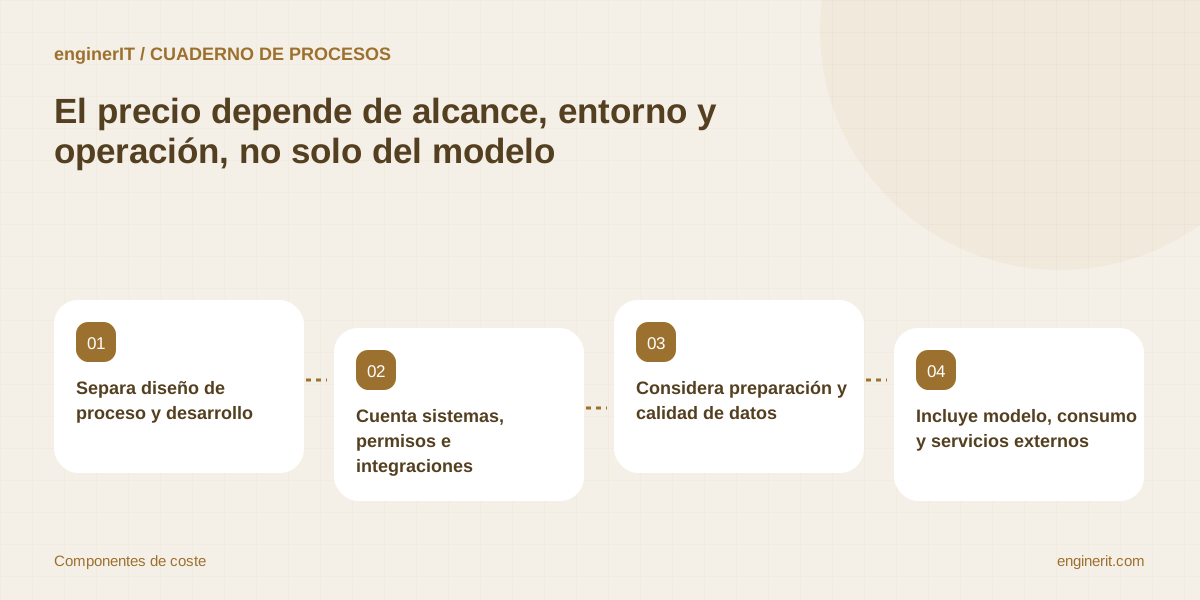
Qué factores determinan el coste de implantar un agente de IA en una pyme
Desglosa descubrimiento, datos, integraciones, supervisión y operación para solicitar presupuestos comparables sin precios inventados.
Leer la guía →