Cómo investigar un fallo de sincronización en una integración SaaS
Sigue un registro desde el evento de origen hasta el destino para localizar si falta, se retrasó o quedó rechazado.
 Equipo enginerIT· 3 min de lectura
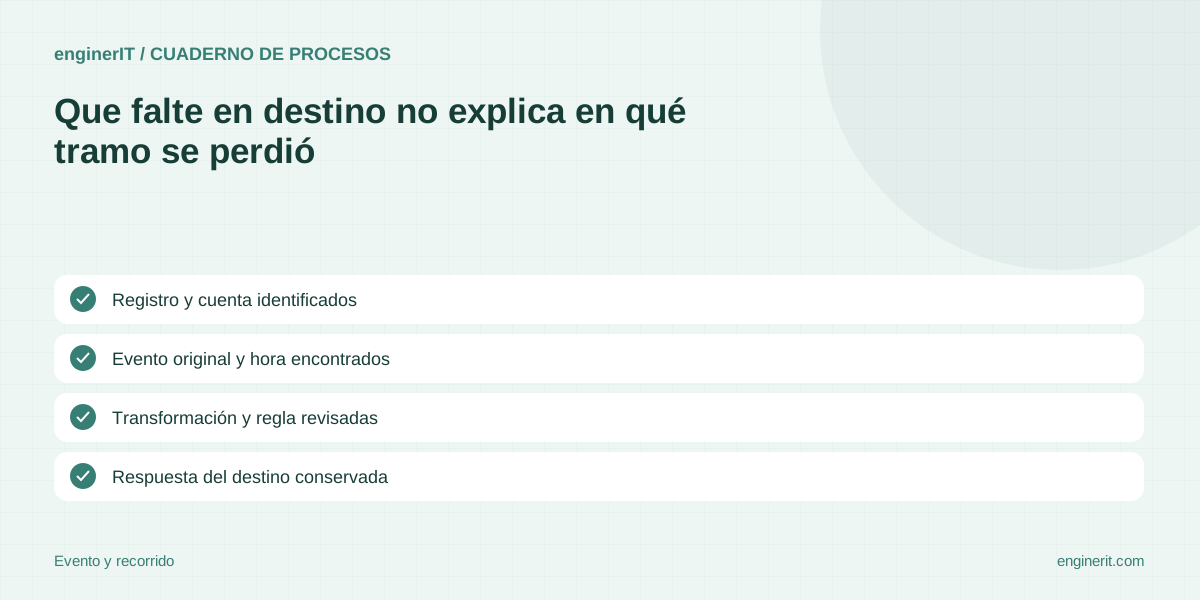
Un registro puede no aparecer en el destino porque el evento no se generó, la cola se retrasó, la transformación lo rechazó o el sistema final respondió con error. Reenviar todo el lote sin localizar el fallo puede crear duplicados y complicar la investigación. El equipo debe seguir una referencia a través de cada etapa y preservar las respuestas que explican qué sucedió.
Delimita cliente, objeto y periodo
Identifica workspace, entidad, registro esperado y ventana temporal, usando el dato mínimo necesario para investigar. Si varias cuentas usan referencias iguales, incorpora el contexto de tenant antes de consultar logs. Evita descargar un conjunto completo de datos cuando el caso afecta a una sola fila.
Busca el evento original y su identificador
Localiza cuándo el sistema fuente detectó el cambio y qué clave de correlación generó. Si no existe, reconstruye la búsqueda con referencias y hora, y registra que la relación es provisional. Una edición manual en destino no demuestra que el evento de origen se haya enviado.
Comprueba cola, latencia y reintentos
Revisa cuándo se procesó, cuánto esperó y si hubo intentos automáticos o manuales. Distingue un evento en cola de uno rechazado. Antes de reenviar, averigua si el primer intento pudo completar la escritura pese a perderse la respuesta del destino.
Valida transformación y datos de entrada
Compara cuerpo recibido, campos derivados y valores normalizados según el mapeo acordado. Busca campos nulos, formato desconocido o claves externas ausentes. No corrijas el registro original para que pase sin guardar qué regla falló y quién autorizó esa transformación.
Lee la respuesta del sistema destino
Conserva código, cuerpo útil, hora y referencia, eliminando secretos y datos no necesarios. Un error de autorización, límite o validación requiere respuesta distinta. Si el destino aceptó el cambio pero la pantalla no lo refleja, investiga caché o lectura antes de escribir de nuevo.
Clasifica el fallo antes de cambiar la lógica
Usa categorías operativas como evento no emitido, rechazo de datos, referencia no encontrada, límite temporal o respuesta incierta. Marca causa como confirmada o hipotética. No despliegues una modificación general desde un caso aislado hasta conocer qué otras filas dependen de la misma regla.
Reintenta solo la unidad y condición validadas
La persona responsable confirma si el evento es idempotente, si el destino ya aplicó la escritura y qué referencia usar para repetirla. Si no puede garantizarse, corrige mediante el mecanismo del proveedor o crea una tarea de reconciliación manual. Evita reintentar un lote entero porque una fila falló.
Confirma el destino y comunica el cierre
Consulta el registro final, compara valores y fecha y pide confirmación al cliente si es necesaria para el proceso. Documenta qué se corrigió y si quedan eventos pendientes. Un ticket cerrado sin esa comprobación solo confirma que alguien ejecutó una acción, no que la sincronización se recuperó.
Antes de ponerlo en marcha
- ✓ Registro y cuenta identificados
- ✓ Evento original y hora encontrados
- ✓ Transformación y regla revisadas
- ✓ Respuesta del destino conservada
- ✓ Reintento comprobado por referencia
- ✓ Responsable y próxima acción asignados
Reconstruye un caso con un evento repetido y una respuesta de destino perdida.
Antes de reintentarlo, confirma si la escritura ya se aplicó. Comprueba que soporte puede distinguir un evento retrasado de uno perdido.
Cuéntanos qué necesitas →Para seguir profundizando
Cómo convertir una incidencia de cliente en un informe reproducible para software
Conserva producto, versión, entorno, pasos y resultado esperado para que soporte y desarrollo investiguen el mismo caso.
Leer la guía →
Cómo registrar una petición funcional de un cliente SaaS sin confundirla con una incidencia
Separa comportamiento esperado, problema de uso y nueva necesidad para que producto reciba contexto comparable.
Leer la guía →
Cómo preparar notas de versión de software desde cambios confirmados
Relaciona cambios publicados, impacto visible y ayuda disponible para comunicar solo lo que llegó al producto.
Leer la guía →