Cómo gestionar alertas de monitorización para muchos clientes desde un MSP
Agrupa señales repetidas sin perder el tenant, distingue alerta de impacto y asigna investigación antes de remediar.
 Equipo enginerIT· 3 min de lectura
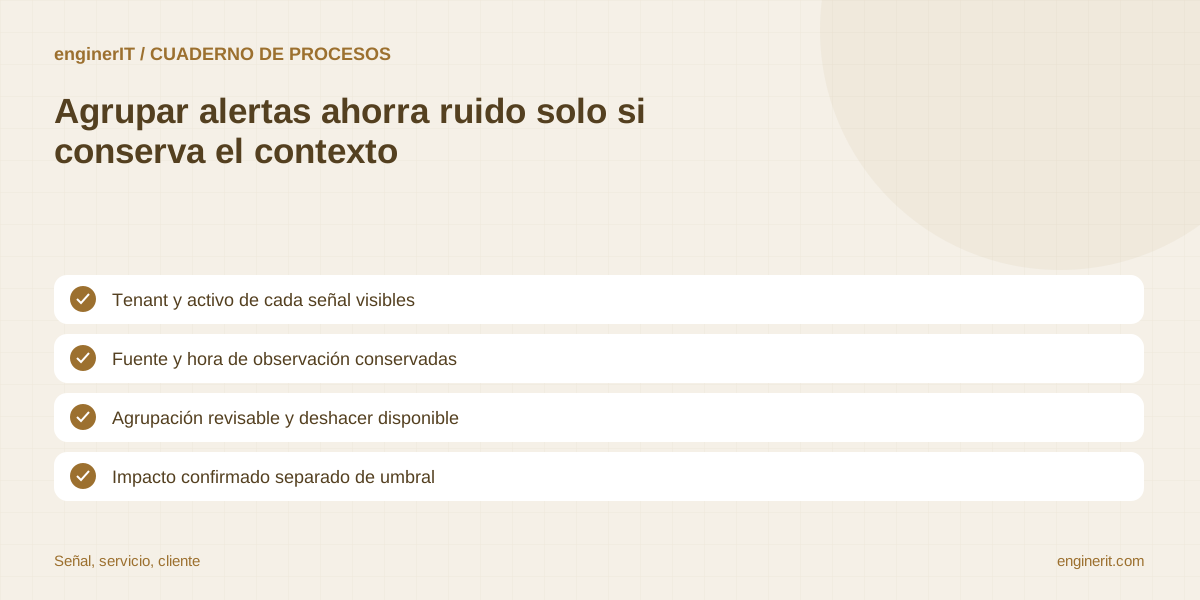
Una plataforma de monitorización puede generar decenas de señales similares durante una interrupción: latencia, reintentos, pérdida de conexión y recuperación. Agruparlas ayuda al equipo a priorizar, pero unir alertas de clientes distintos puede ocultar fallos independientes o ejecutar una acción sobre el tenant equivocado. La automatización necesita preservar origen y permitir que cada entorno se investigue con sus permisos.
Conserva tenant, activo, monitor y ventana temporal
Cada alerta agrupada mantiene la empresa, identificador del activo, sistema que midió, hora y condición observada. No elimines señales originales al crear un incidente padre. El técnico debe poder abrir los eventos que explican la agrupación y separarlos si la causa común era solo aparente.
Define cuándo dos señales pertenecen al mismo episodio
Puede haber relación por activo, dependencia confirmada, correlación temporal o causa investigada. La similitud de texto no basta para agrupar automáticamente dos clientes. Empieza con sugerencias revisables y registra la regla utilizada, quién aceptó la agrupación y cómo deshacerla.
Diferencia un umbral de un impacto empresarial
Un monitor que excede un valor detecta una condición técnica, no necesariamente un servicio detenido. Registra si la afectación al usuario fue confirmada, inferida o todavía desconocida. La respuesta inicial puede pedir verificación y asignar investigación antes de comunicar una caída como hecho.
Ordena la cola con criterios explícitos
El MSP puede priorizar criticidad configurada del activo, alcance confirmado, duración y alertas repetidas. Muestra qué campos influyeron para que un técnico corrija datos obsoletos. Evita una prioridad idéntica para todos los clientes si contratos, servicios y ventanas acordadas difieren.
Limita las acciones de contención al tenant
Reiniciar servicio, aislar endpoint o modificar una regla puede afectar usuarios y evidencia. Un agente puede reunir el comando y contexto para revisión, pero no debe aplicar un remedio genérico a varios clientes por una alerta compartida. Exige permiso, alcance y condición de reversión por entorno.
Comunica solo lo que el monitor confirma
Un borrador explica qué alarma se observó, desde cuándo y qué comprobación está en curso. No afirma pérdida de datos, resolución o impacto general sin evidencia. El contacto y canal se obtienen del registro actualizado del cliente, no de una lista de distribución reutilizada sin comprobar.
Reconoce alertas silenciosas y estado recuperado
El flujo registra tanto la apertura como la recuperación y vigila señales que dejan de llegar. La ausencia de eventos no debe contarse como normalidad si se perdió el propio agente de monitorización. Define una alerta distinta para falta de telemetría y asigna su investigación.
Aprende de falsos positivos sin desactivar cobertura a ciegas
Revisa por cliente qué alertas no requerían actuación, cuánto trabajo generaron y qué cambios de umbral se proponen. Una persona valida la nueva regla y comprueba qué escenarios dejaría de detectar. Conserva versión anterior y método para restaurarla si aparecen casos omitidos.
Antes de ponerlo en marcha
- ✓ Tenant y activo de cada señal visibles
- ✓ Fuente y hora de observación conservadas
- ✓ Agrupación revisable y deshacer disponible
- ✓ Impacto confirmado separado de umbral
- ✓ Acción correctiva con aprobación y límite
- ✓ Comunicación ligada a evidencia del cliente
Reproduce una alerta parecida en dos tenants durante la misma mañana.
Confirma que la deduplicación mantiene ambos clientes separados y que una señal desaparecida también crea una investigación.
Cuéntanos qué necesitas →Para seguir profundizando
Cómo clasificar tickets en un MSP sin mezclar datos de distintos clientes
Diseña una entrada con tenant, servicio contratado, prioridad revisable y permisos que eviten respuestas en la cuenta equivocada.
Leer la guía →
Cómo coordinar un cambio técnico de MSP con aprobación y ventana del cliente
Prepara alcance, impacto, ventana, responsable y vuelta atrás antes de ejecutar una modificación en un entorno gestionado.
Leer la guía →
Cómo mantener el inventario de activos IT actualizado en un MSP multiempresa
Concilia altas, bajas, sustituciones y cambios de propietario por tenant, conservando origen y discrepancias.
Leer la guía →