Cómo evaluar las acciones de un agente de IA, no solo sus respuestas
Revisa consulta, argumentos, permisos, duplicados y estado final de cada herramienta usada por el agente.
 Equipo enginerIT· 3 min de lectura
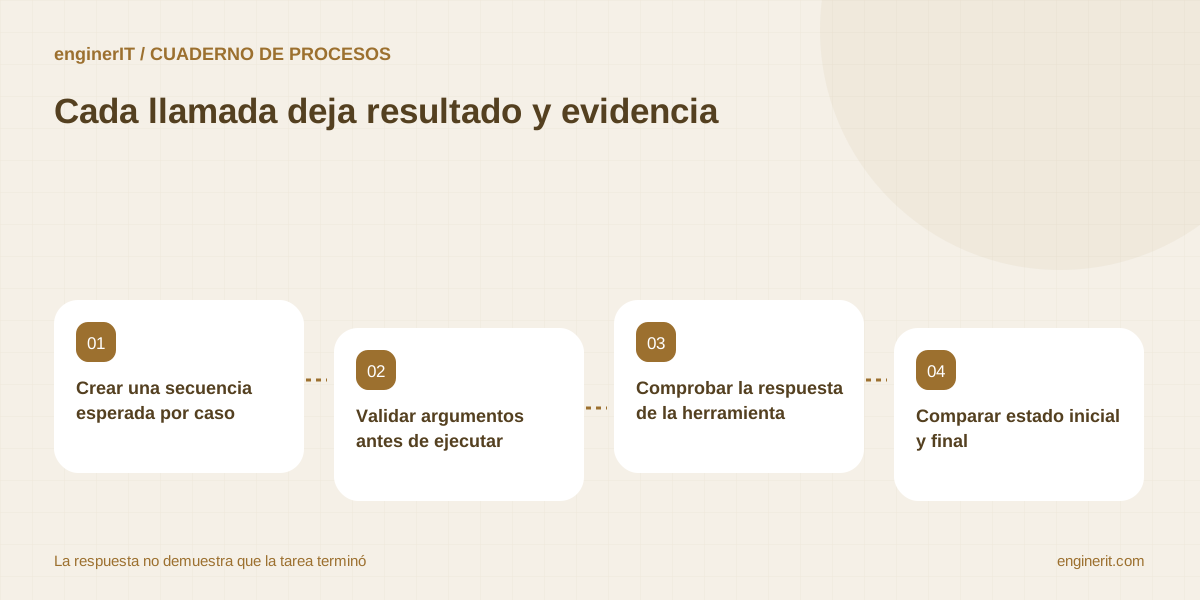
Un agente puede anunciar “pedido actualizado” aunque la API haya rechazado la escritura, haya modificado el pedido equivocado o haya repetido una acción después de un timeout. Si la evaluación solo califica la respuesta final, estos defectos permanecen ocultos. La prueba debe seguir el ciclo: entrada, decisión, herramienta elegida, parámetros, resultado y estado confirmado. Esta revisión es especialmente importante cuando el agente puede crear tareas, cambiar datos de clientes o ejecutar una operación financiera.
Crear una secuencia esperada por caso
Para cada entrada, describe lectura permitida, llamada necesaria, campos que deben incluirse y resultado que confirma éxito. Incluye caminos alternativos cuando una búsqueda devuelve cero, un resultado o varios. El agente no tiene que seguir una secuencia rígida si otra forma cumple las reglas, pero el criterio debe ser comprobable.
Validar argumentos antes de ejecutar
Compara identificadores, tenant, destinatario, importe, fecha y campos permitidos con el caso esperado. Detecta datos inventados y valores heredados de otro expediente. En producción, el sistema destino debe aplicar autorización; la evaluación verifica también que el agente no supere el ámbito concedido.
Comprobar la respuesta de la herramienta
Un código 200 puede contener rechazo funcional o una tarea incompleta. Inspecciona estado, identificador creado y campos relevantes después de la llamada. Si hay timeout, consulta el destino antes de reintentar. Una prueba debe contar duplicados aunque el mensaje final sea correcto.
Comparar estado inicial y final
Registra valores relevantes antes y después, con entorno aislado o datos sintéticos. Confirma que solo cambió lo autorizado y que otros campos permanecen intactos. El test no debe ejecutarse sobre cuentas reales ni causar mensajes externos.
Evaluar recuperación y límites
Incluye permisos denegados, respuesta malformada, conexión caída y datos conflictivos. El resultado correcto puede ser detenerse, conservar borrador y derivar. Penaliza una acción exitosa en el sistema equivocado más que una derivación segura.
Separar fallos del agente y de integración
Etiqueta causa: selección de herramienta, extracción, autorización, API, estado tardío, duplicado o respuesta engañosa. Mantén evidencia técnica para diagnóstico. Si se cambia una integración, ejecuta la misma prueba sin alterar criterios de éxito del agente.
Establecer controles de liberación
Bloquea el despliegue si fallan casos de alto impacto o si la evidencia no permite atribuir la acción. Revisa tendencias por herramienta y categoría, no solo promedio. Cambios de modelo o permisos exigen ejecutar el conjunto de regresión antes de volver a producción.
Fuentes y documentación
- Anthropic — Demystifying evals for AI agents — Describe evaluación de pasos y resultados en sistemas agentivos.
- NIST AI RMF — Measure function — NIST AI RMF calls for documented test sets, metrics, methods, human oversight, and monitoring in the deployment context.
Simula un timeout después de que el sistema destino sí aplicó la acción.
El agente debe confirmar el estado por identificador y no crear una segunda operación.
Cuéntanos qué necesitas →Para seguir profundizando
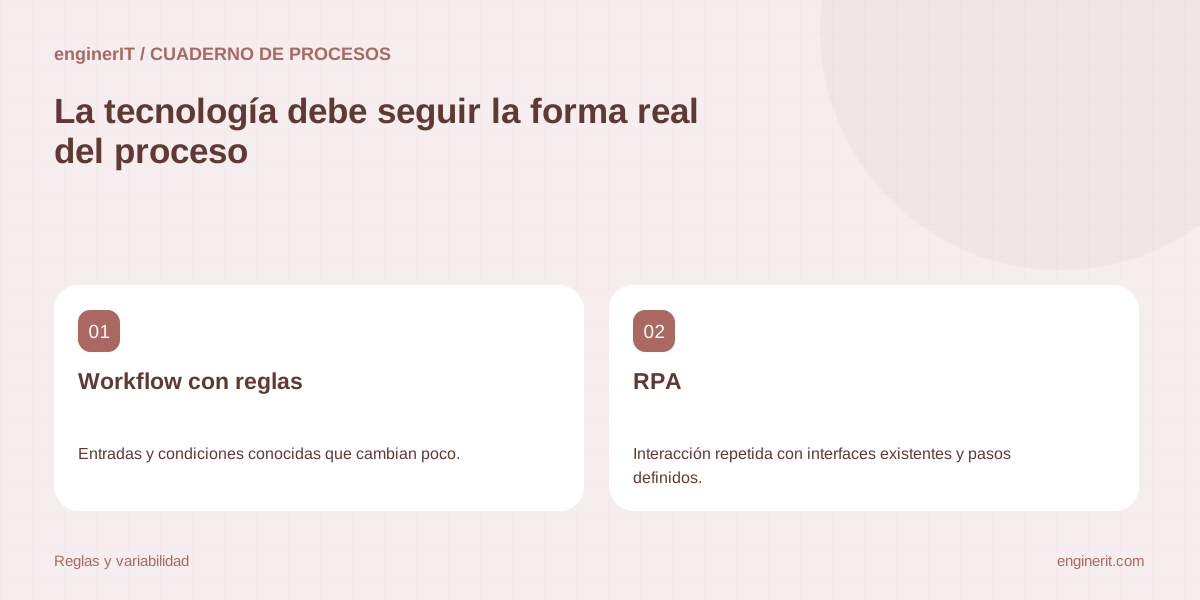
Workflow, RPA o agente de IA: cómo elegir el tipo de automatización
Compara variabilidad, fuentes, decisiones y tolerancia a errores para seleccionar una solución que encaje con el proceso.
Leer la guía →
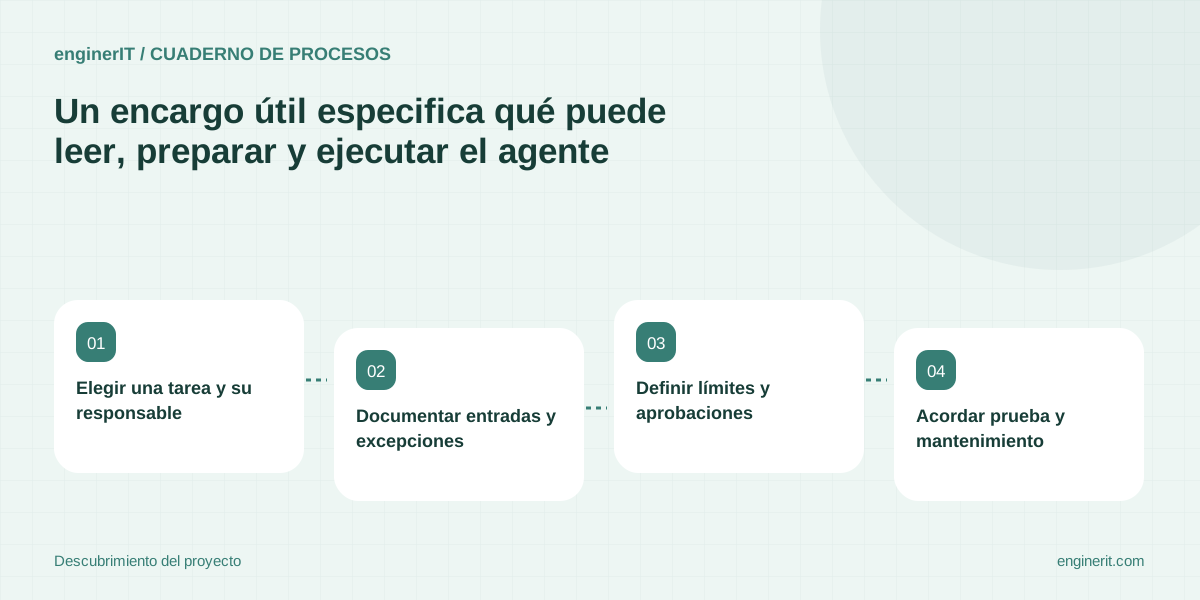
Cómo preparar los requisitos de un proyecto de agente de IA para una empresa
Define tarea, fuentes, acciones, límites, supervisión y criterios de aceptación antes de pedir una propuesta.
Leer la guía →
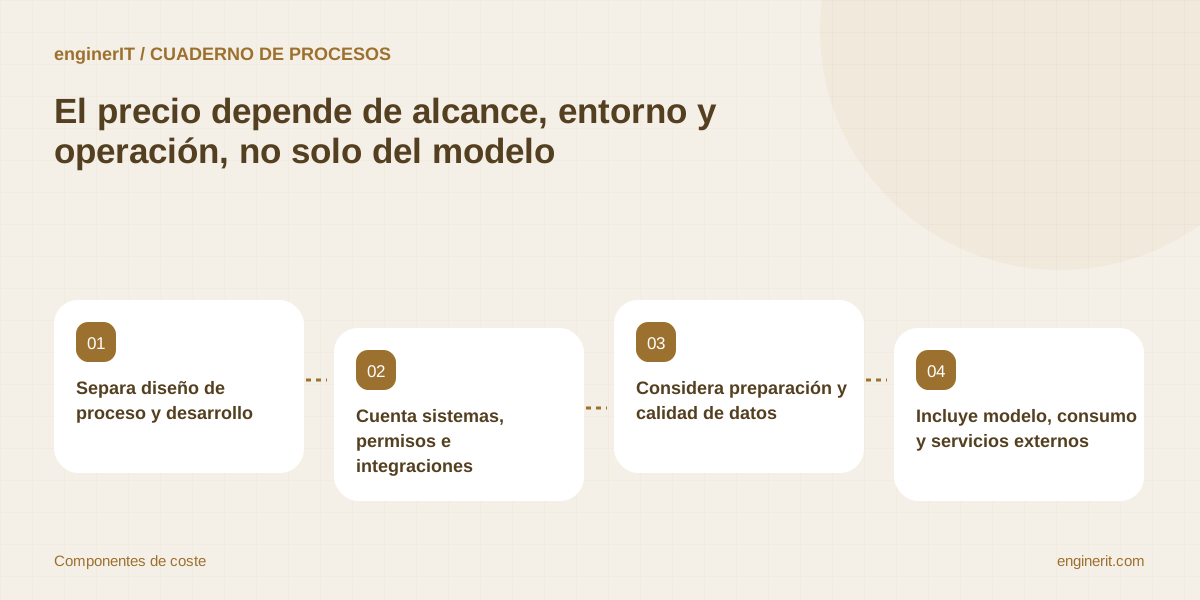
Qué factores determinan el coste de implantar un agente de IA en una pyme
Desglosa descubrimiento, datos, integraciones, supervisión y operación para solicitar presupuestos comparables sin precios inventados.
Leer la guía →