Cómo crear un conjunto de pruebas útil para un agente de IA
Construye casos representativos con respuestas esperadas, excepciones, datos desactualizados y criterios de aprobación.
 Equipo enginerIT· 3 min de lectura
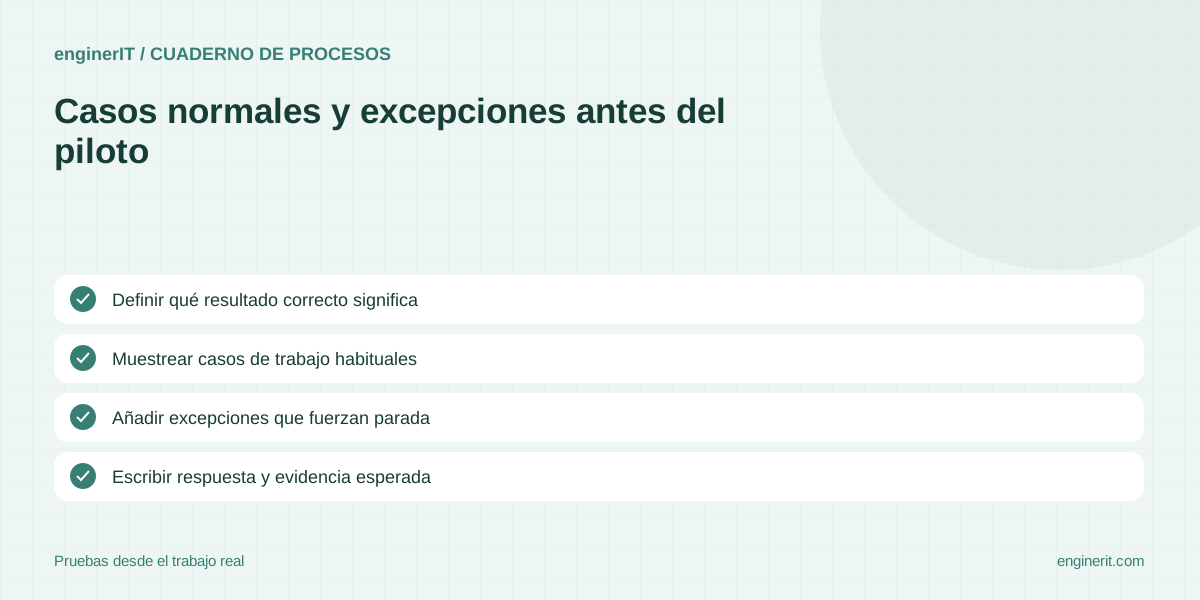
Un agente puede responder bien a cinco ejemplos elegidos por el equipo y fallar cuando falta un dato, cambia la versión de una política o recibe dos instrucciones contradictorias. Un conjunto de pruebas convierte el proceso en casos repetibles. NIST recomienda documentar test sets, métricas y condiciones de evaluación; los agentes también necesitan comprobar acciones y estados intermedios. Para una pyme, no hace falta empezar con miles de ejemplos: hace falta cubrir decisiones reales que el flujo debe tomar y reconocer cuándo debe detenerse.
Definir qué resultado correcto significa
Describe la tarea y el estado final observable: consulta resuelta con fuente, borrador creado en la cola correcta, o transferencia con los datos necesarios. Evita criterios vagos como “buena respuesta”. Define qué condiciones invalidan el resultado aunque el texto parezca útil.
Muestrear casos de trabajo habituales
Reúne ejemplos reales anonimizados de entradas, documentos y preguntas. Incluye variaciones de canal, idioma, formato y vocabulario. Guarda contexto suficiente para reconstruir el caso, pero elimina datos que no necesitas para evaluar.
Añadir excepciones que fuerzan parada
Incluye dato ausente, fuente contradictoria, cliente no identificado, acción duplicada y solicitud fuera de política. Especifica qué debe hacer el agente: pedir aclaración, transferir, mostrar incertidumbre o no ejecutar. Una prueba solo de casos felices exagera la preparación.
Escribir respuesta y evidencia esperada
Para cada caso, anota resultado permitido, fuente autorizada, campos que debe conservar y acción prohibida. Si hay varias respuestas aceptables, explica el rango. Pide a alguien del proceso que revise ejemplos y resuelva desacuerdos antes de usarlos como referencia.
Evaluar texto, herramientas y estado
Comprueba si consultó el sistema correcto, llamó la herramienta esperada, modificó solo registros autorizados y dejó la operación en estado correcto. Revisa argumentos de herramientas y resultado final. Un mensaje correcto que creó dos tareas o utilizó otro cliente es un fallo.
Versionar datos, reglas y modelo
Cada ejecución identifica versión del conjunto, prompt, herramientas, fuente documental y modelo. No cambies un caso esperado en silencio para que el sistema parezca mejorar. Anota quién revisó un cambio y qué comportamiento nuevo se acepta.
Usar pruebas para decidir el despliegue
Define umbral por clase de riesgo, tasa de derivación aceptable y errores que bloquean lanzamiento. Un promedio global no compensa un fallo grave en la categoría sensible. Documenta límites, casos no cubiertos y responsable de repetir pruebas después de cambios.
Fuentes y documentación
- NIST AI RMF — Measure function — NIST AI RMF calls for documented test sets, metrics, methods, human oversight, and monitoring in the deployment context.
- Anthropic — Demystifying evals for AI agents — Los agentes requieren evaluar secuencias de herramientas y cambios de estado, no solo texto final.
Empieza con 20 casos habituales y diez excepciones observadas.
Conserva un resultado correcto y un motivo de fallo para que el equipo pueda revisar cada cambio.
Cuéntanos qué necesitas →Para seguir profundizando
Workflow, RPA o agente de IA: cómo elegir el tipo de automatización
Compara variabilidad, fuentes, decisiones y tolerancia a errores para seleccionar una solución que encaje con el proceso.
Leer la guía →
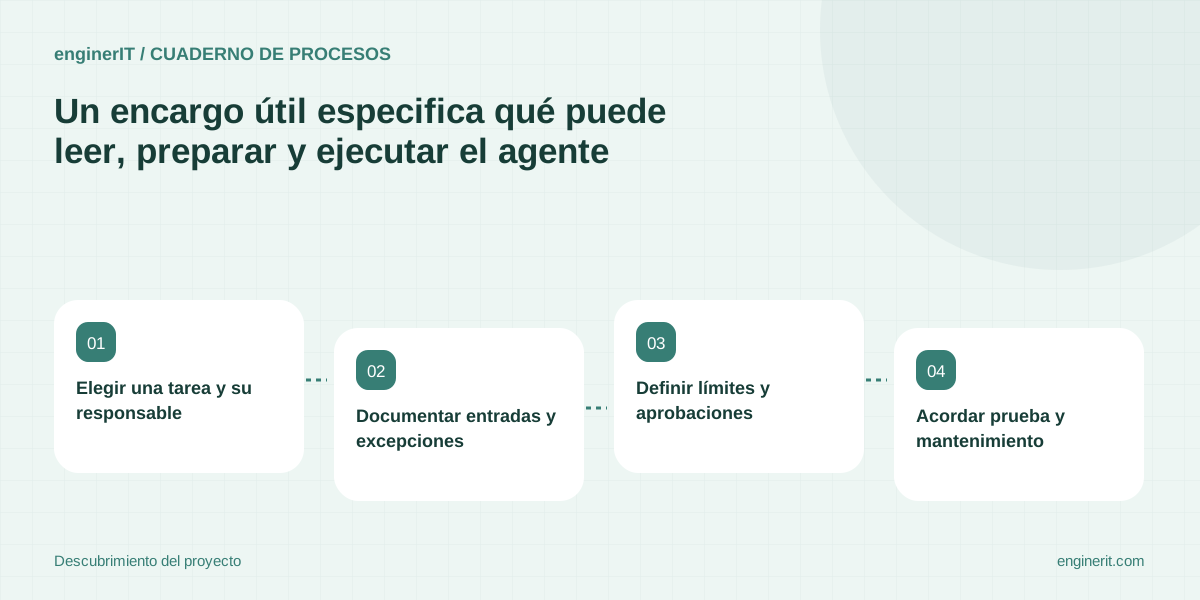
Cómo preparar los requisitos de un proyecto de agente de IA para una empresa
Define tarea, fuentes, acciones, límites, supervisión y criterios de aceptación antes de pedir una propuesta.
Leer la guía →
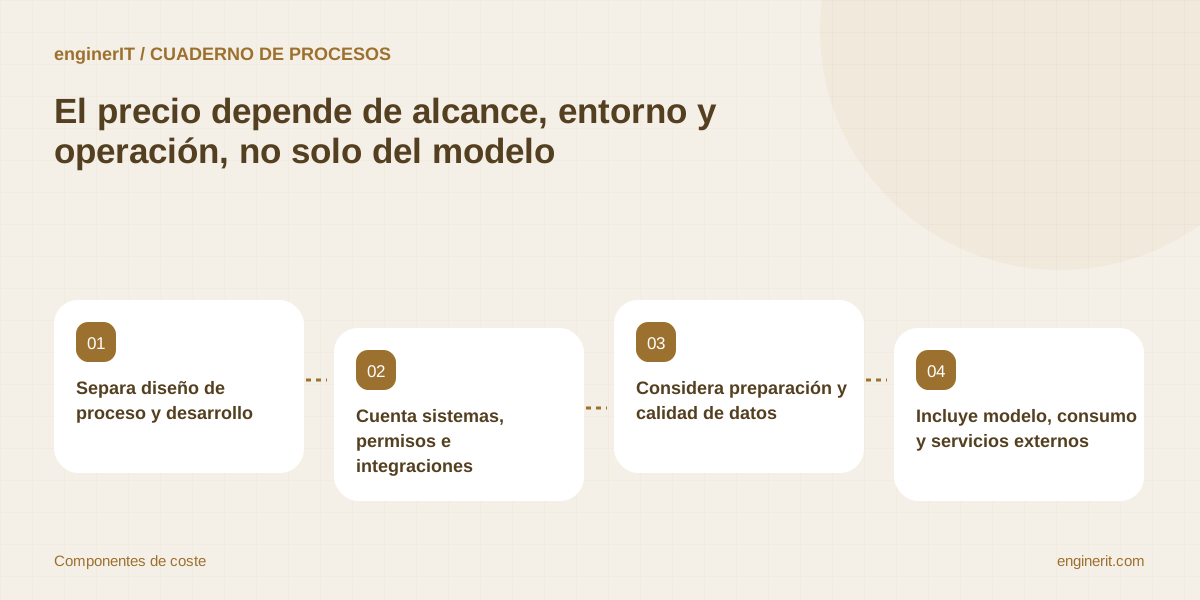
Qué factores determinan el coste de implantar un agente de IA en una pyme
Desglosa descubrimiento, datos, integraciones, supervisión y operación para solicitar presupuestos comparables sin precios inventados.
Leer la guía →